AI Twitter 热点 · 2026-09-23
AI Twitter/X 热点 Digest · 2026-09-23(周三)
今日要点
- Claude Opus 5.5 发布:对标 Fable 5.1 智力、比 Opus 5 更便宜;成为 Claude Code 默认模型,并迅速上到 Cursor / Factory。
- 约一百分钟后 GPT-6 Sol / Luna 跟进:强调 coding / computer use,API 价格再砍约一半;Devin 同日接入。
- OpenCode 2.0 谈「会话中实时改自身」;Grok 4.7 进入次日实战与批评;harness / Jev / Cline 继续占讨论。
1. Claude Opus 5.5:Claude 5.5 家族首发,默认进 Claude Code
要点:@claudeai 发布 Claude Opus 5.5——Claude 5.5 家族第一款,称多数任务达到 Fable 5.1 水平,运行成本比 Opus 5 低约 40%。@trq212 强调更清晰的沟通、更高 token 效率,并上调 5 小时额度、赠送 banked reset。@_catwu 宣布它已成为 Claude Code / Claude app(含 Cowork) 在 Pro / Max / Team 上的默认模型,默认 effort medium。@bcherny 用「把 HAProxy 从 C 迁到 Rust」对比:Opus 5.5 约 9.5 小时 对 Fable 5.1 的 12 小时,成本约低 51%。
为何值得看:定价与默认入口同时动——模型公告之外,coding agent 默认栈当天就切了。
- 发布:https://x.com/claudeai/status/2102435511222890900
- Anthropic:https://x.com/AnthropicAI/status/2102435703535939725
- 产品反馈:https://x.com/trq212/status/2102437686967738431
- Claude Code 默认:https://x.com/_catwu/status/2102437713781944397
- HAProxy 实验:https://x.com/bcherny/status/2102439069053747549
2. GPT-6 Sol / Luna:更快更便宜的「宇宙」扩容
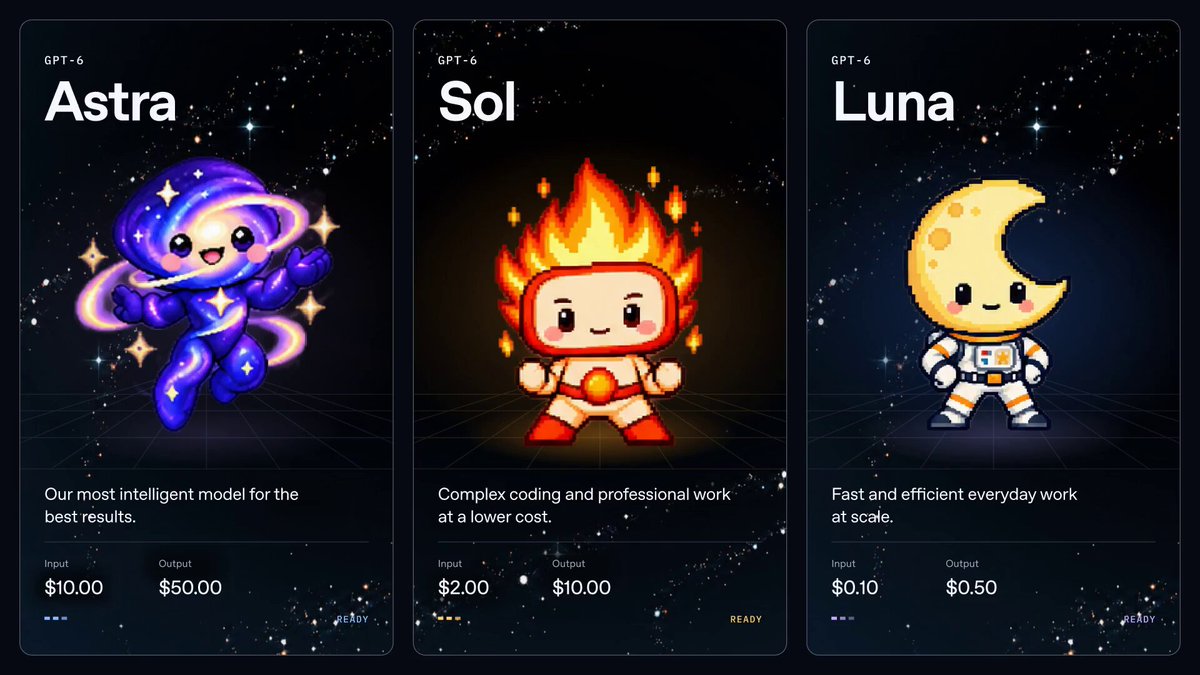
要点:@OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna,称承接 GPT-6 Astra 的能力,做成更快、更适合规模化的型号,并相对 GPT‑5.6 促销价把 API 价再降约 50%。@sama 点名智力、对齐、产出、coding、computer use 全面提升,且「按任务计」更便宜。@thsottiaux 强调写作手感与订阅侧 banked reset;@polynoamial 称 Luna 到约 $0.10 / $0.50 per 1M tokens。
为何值得看:与 Opus 5.5 几乎同日对打,叙事都是「更强 + 更便宜 + 更适合 agent 长跑」。
- 发布:https://x.com/OpenAI/status/2102460975790137662
- 手感与降价:https://x.com/thsottiaux/status/2102463847714247142
- coding / computer use:https://x.com/sama/status/2102464672519815512
- 价格细节:https://x.com/polynoamial/status/2102464815751111057
3. Cursor:Opus 5.5 上线,CursorBench 新高
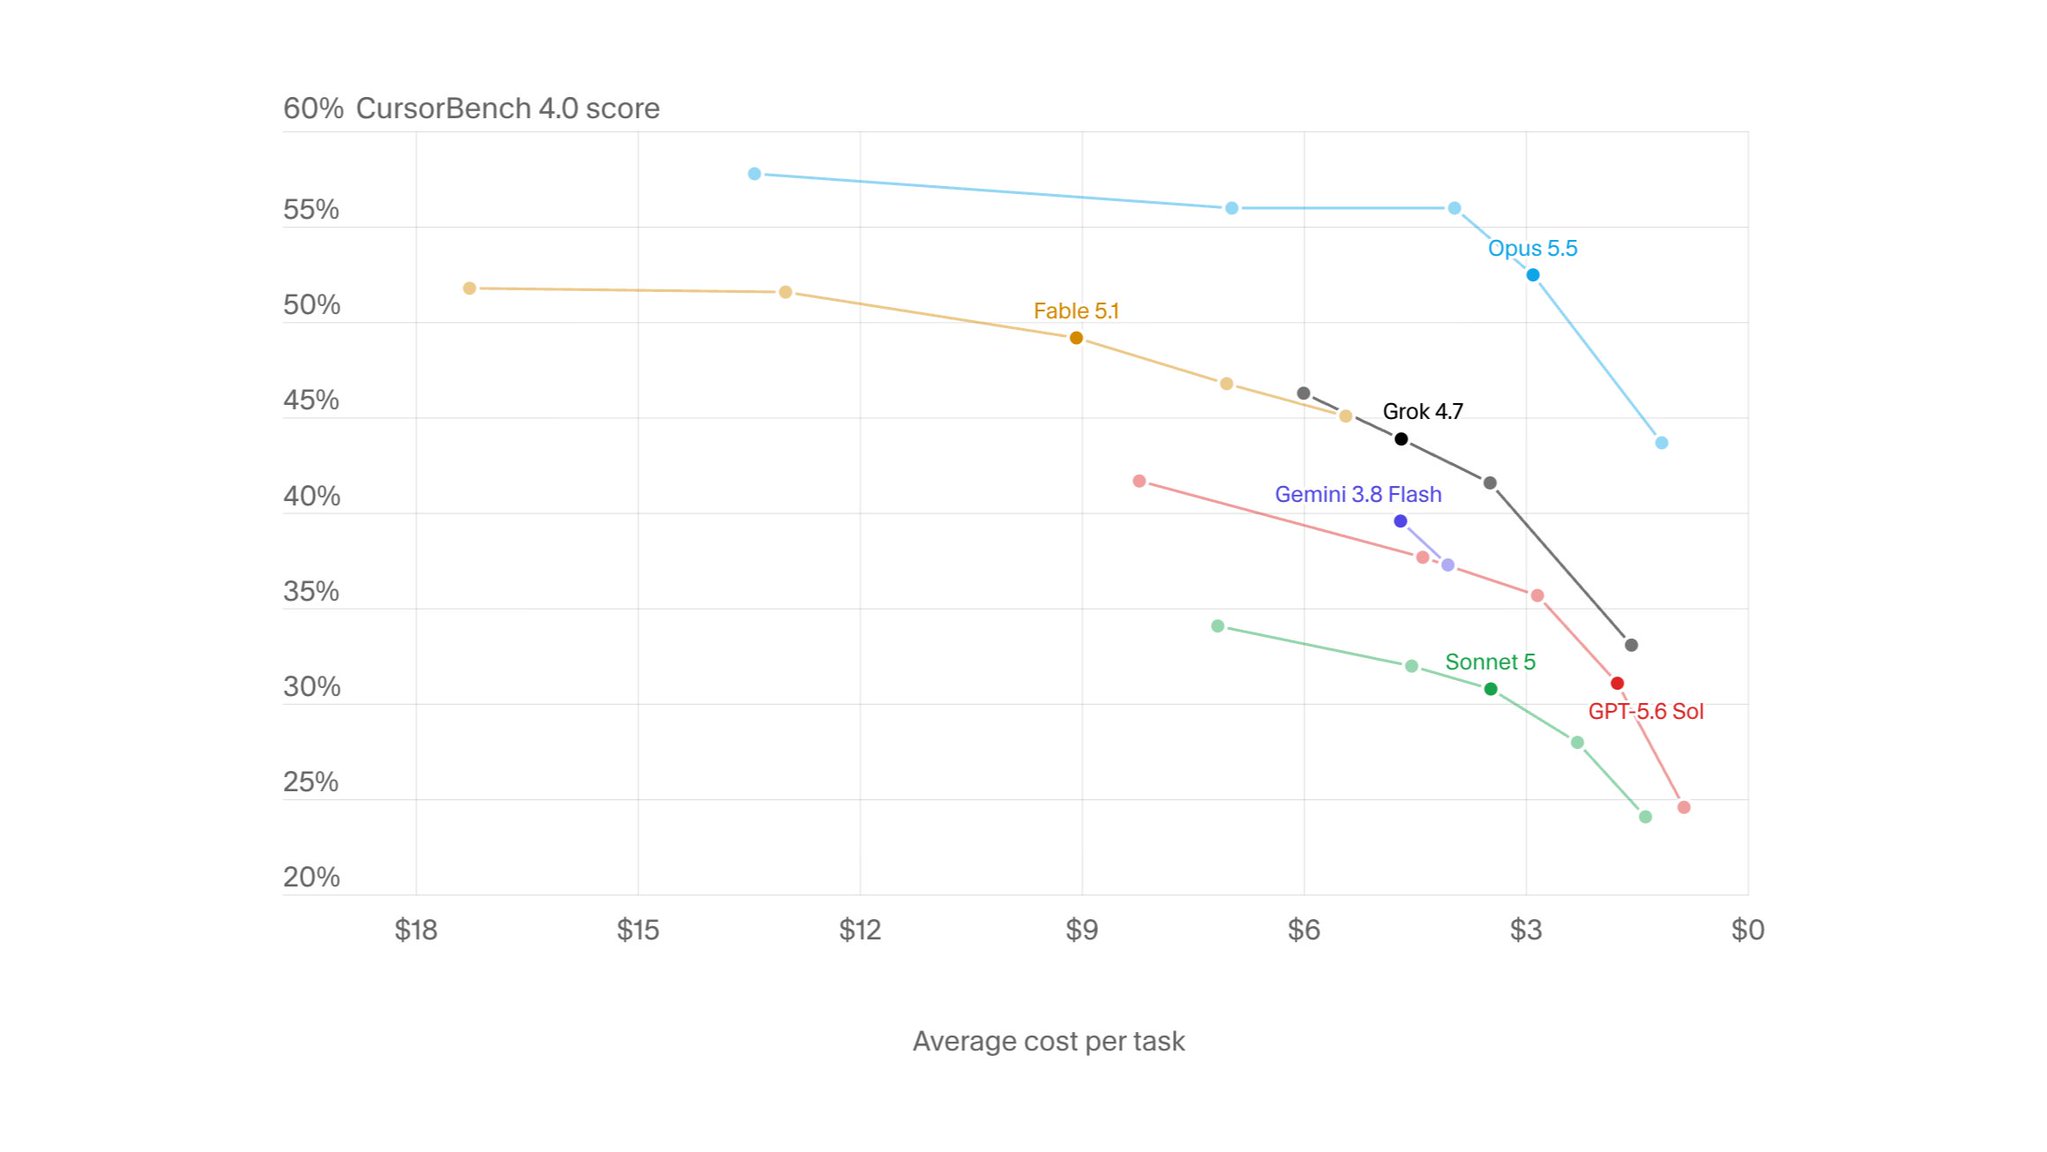
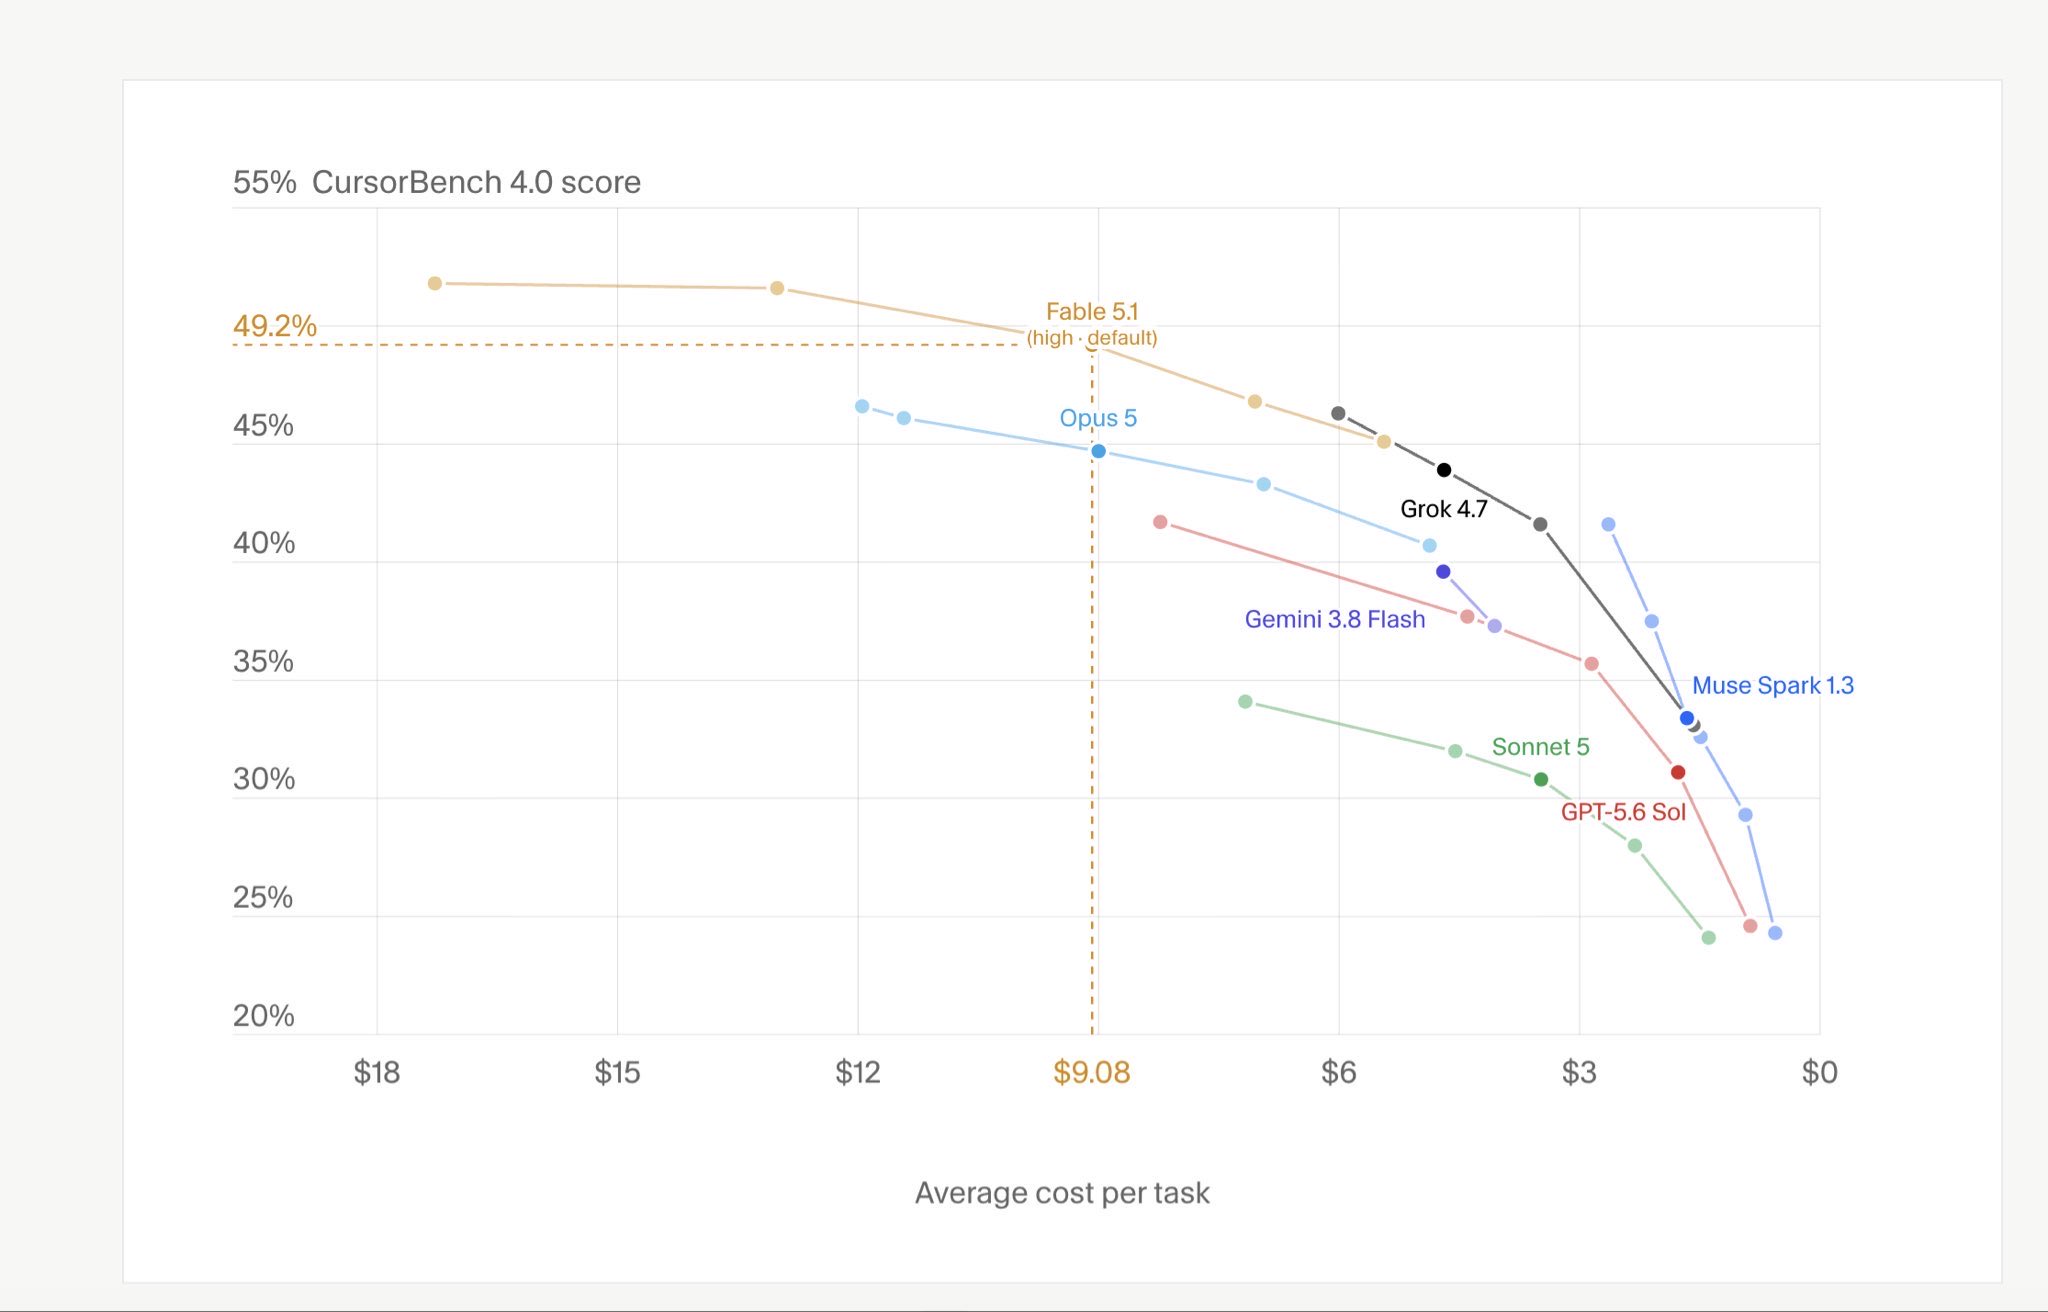
要点:@cursor_ai 宣布 Claude Opus 5.5 已在 Cursor 可用,CursorBench Max 到 57.8%,单任务成本约比 Opus 5 低 40%。中文圈 @MaiYangAI 则把 @poteto 的 Cursor Compile 长视频配了字幕,重提「米其林厨房」而不是「软件工厂」——agent 可以代炒,成品仍归厨子负责。
为何值得看:新模型分发战里,IDE 侧用自有榜单接住「默认换模」;社区侧继续补「人怎么带代理合 PR」。
- Opus 5.5 in Cursor:https://x.com/cursor_ai/status/2102448392773435706
- Compile 中文字幕版:https://x.com/MaiYangAI/status/2102344659276099794
4. Devin:接入 GPT-6 Sol / Luna,FrontierCode 成本再压
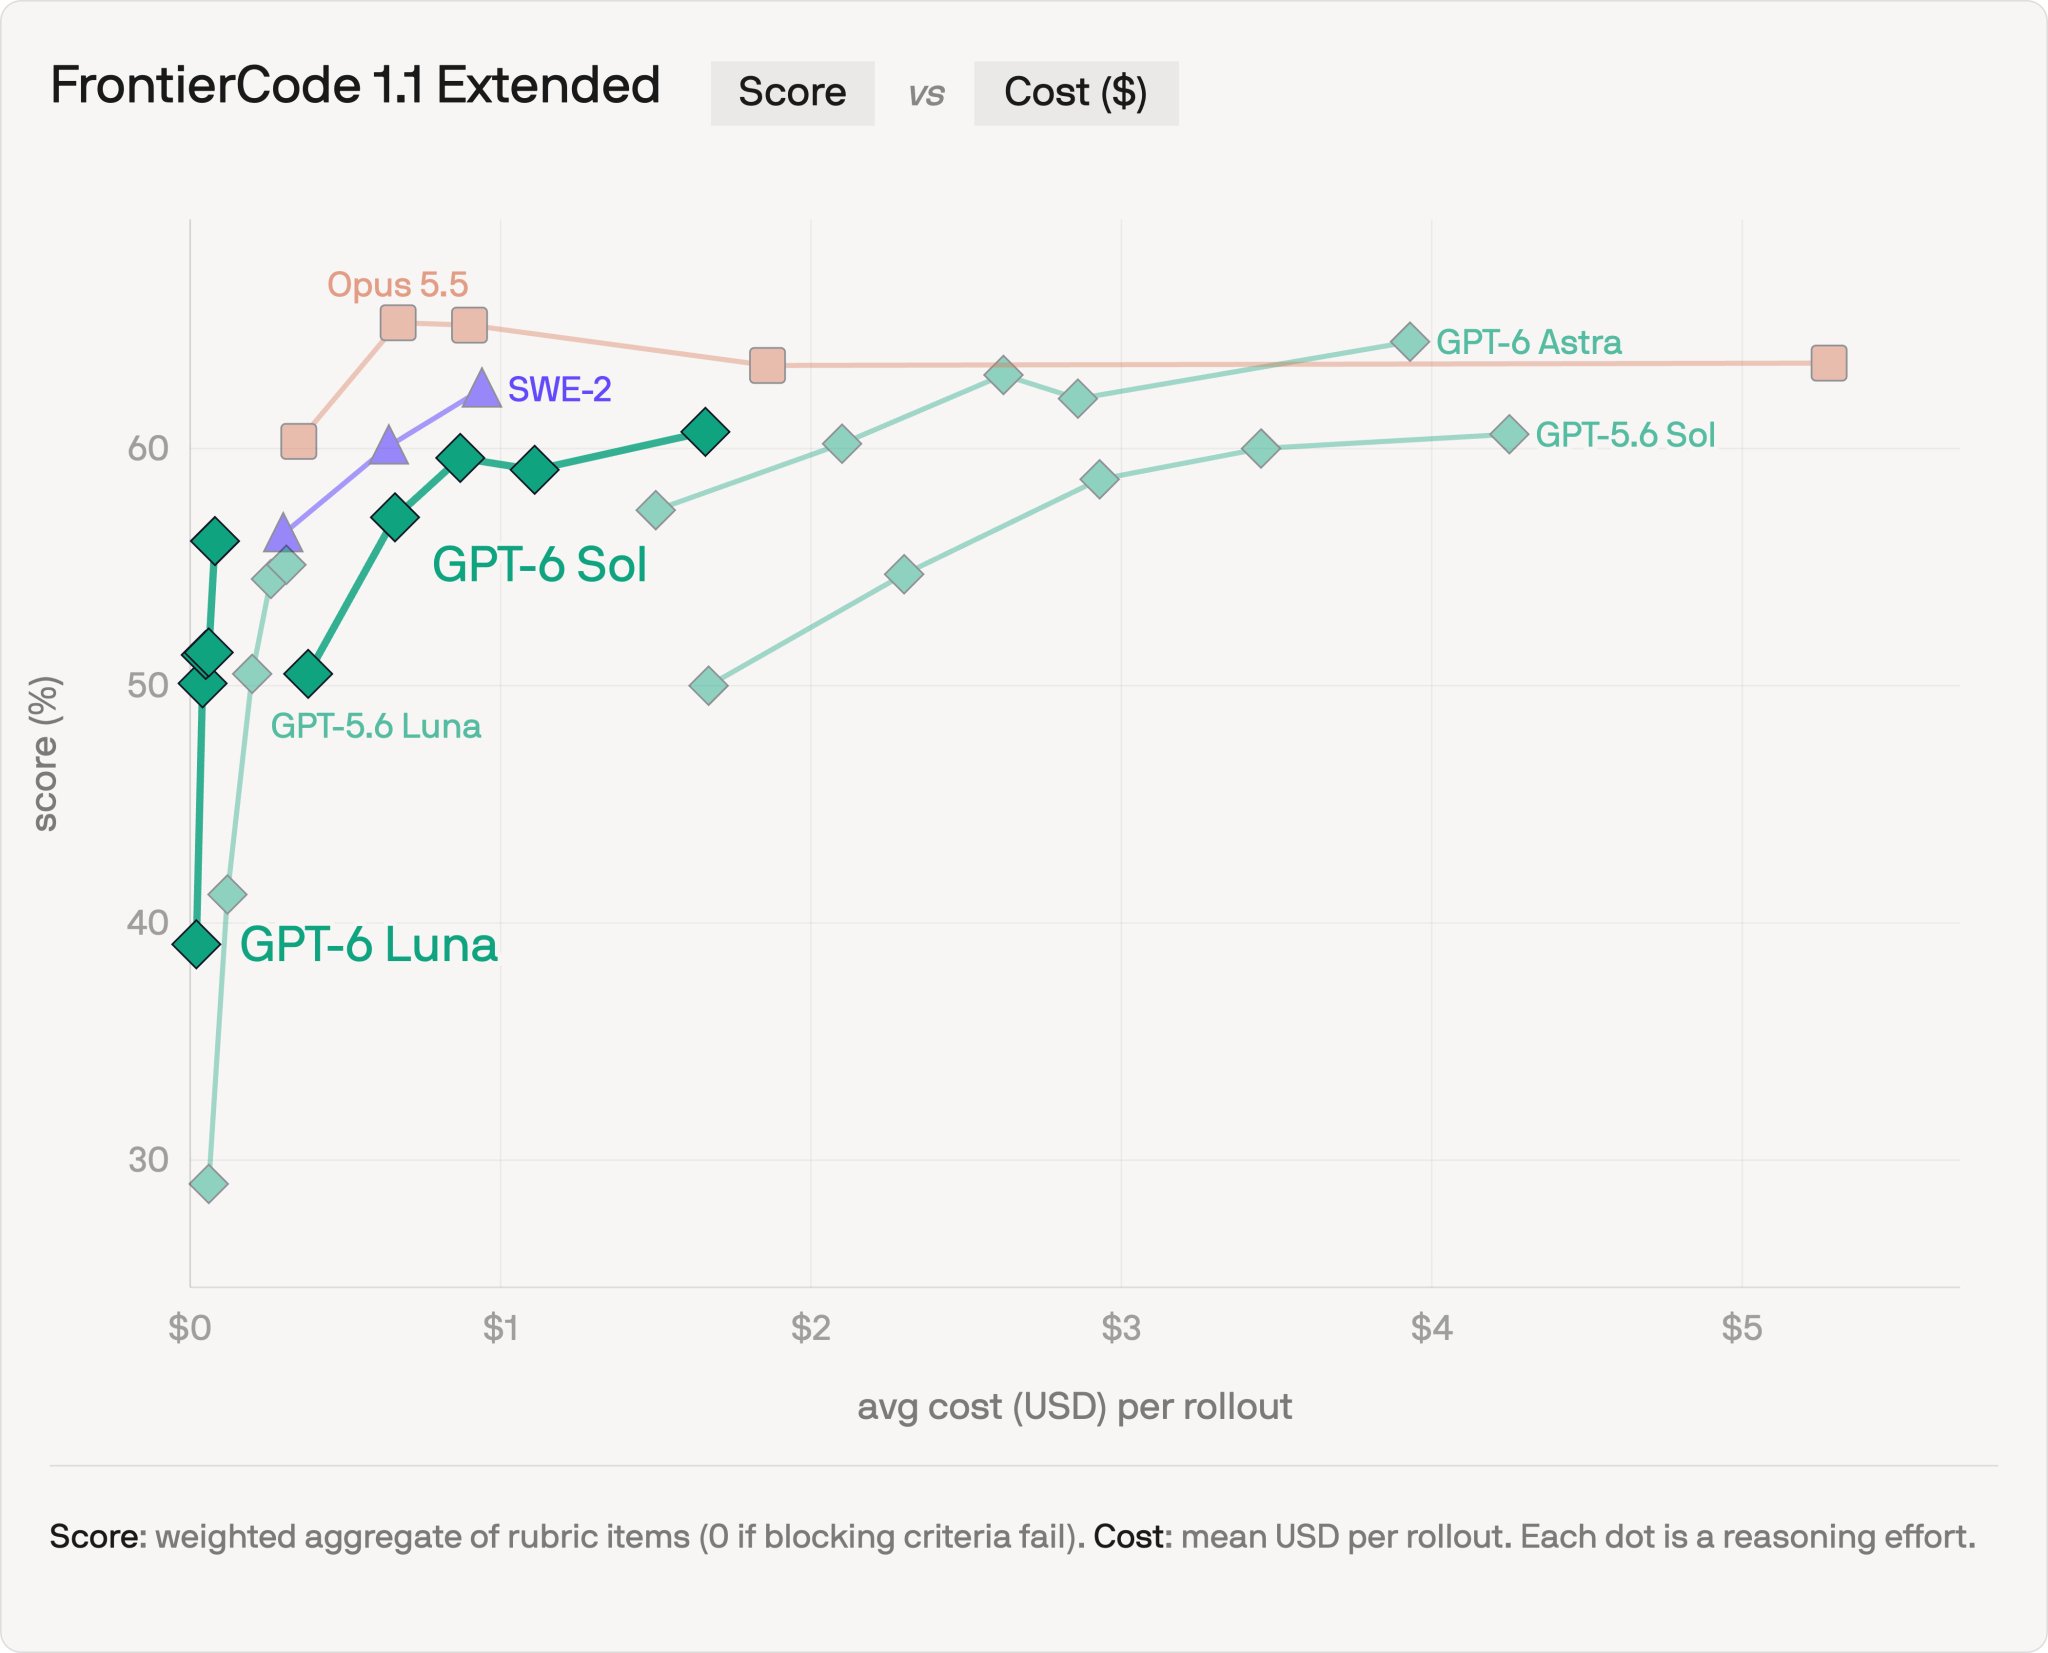
要点:@cognition 宣布 GPT-6 Sol / Luna 已可在 Devin 使用。FrontierCode 1.1 上,Sol 对齐上一代 Sol 分数但单任务成本约低 61%;Luna 高于上一代 Luna,且成本约四分之一,号称榜上最便宜档(约 <$0.10 / task)。
为何值得看:云端 coding agent 继续当「新模型落地的第二天」入口,评测口径直接落到 $/task。
- 链接:https://x.com/cognition/status/2102463672224543018
5. OpenCode 2.0:会话中实时改写自身
要点:@thdxr 放出 kit 写完的长文,讲 OpenCode 2.0 如何在仍在跑的 session 里实时修改自身行为与结构,并邀请大家挖彩蛋。终端选手 @skywind3000 则吐槽本地体验:opencode 手感差、pi 难用、codex 太简陋,只好继续 Claude Code——侧面说明「开源 harness」与「默认好用」仍两回事。
为何值得看:代理产品开始把「可热更新的 harness」本身当成卖点,而不只是换模型。
- OpenCode 2.0 长文:https://x.com/thdxr/status/2102206622000967955
- 终端对比:https://x.com/skywind3000/status/2102377526656139274
6. Grok 4.7 次日:Tesla 工程叙事 vs 实战批评
要点:发布次日,@elonmusk 继续推 Grok 4.7 + Build harness 当日常主力,并称其在 Tesla 做真实工程。@theo 长帖则更不客气:相对 4.6,token 效率更差、部分榜更弱、真实成本可超 2×,前端 / 3D 与「卡死循环」仍像 2025——认为这是一次令人失望的发布。
为何值得看:昨天是「上线与分发」,今天是「harness 叙事 vs 真实账单与手感」开始掰扯。
- Build harness 日用:https://x.com/elonmusk/status/2102412363332805078
- Tesla 工程:https://x.com/elonmusk/status/2102423241897705926
- 批评长帖:https://x.com/theo/status/2102259624313549130
- 模型卡图:https://x.com/elonmusk/status/2102207241101144450
7. Harness 决定上限:ReFigBench 与 Managed Agents
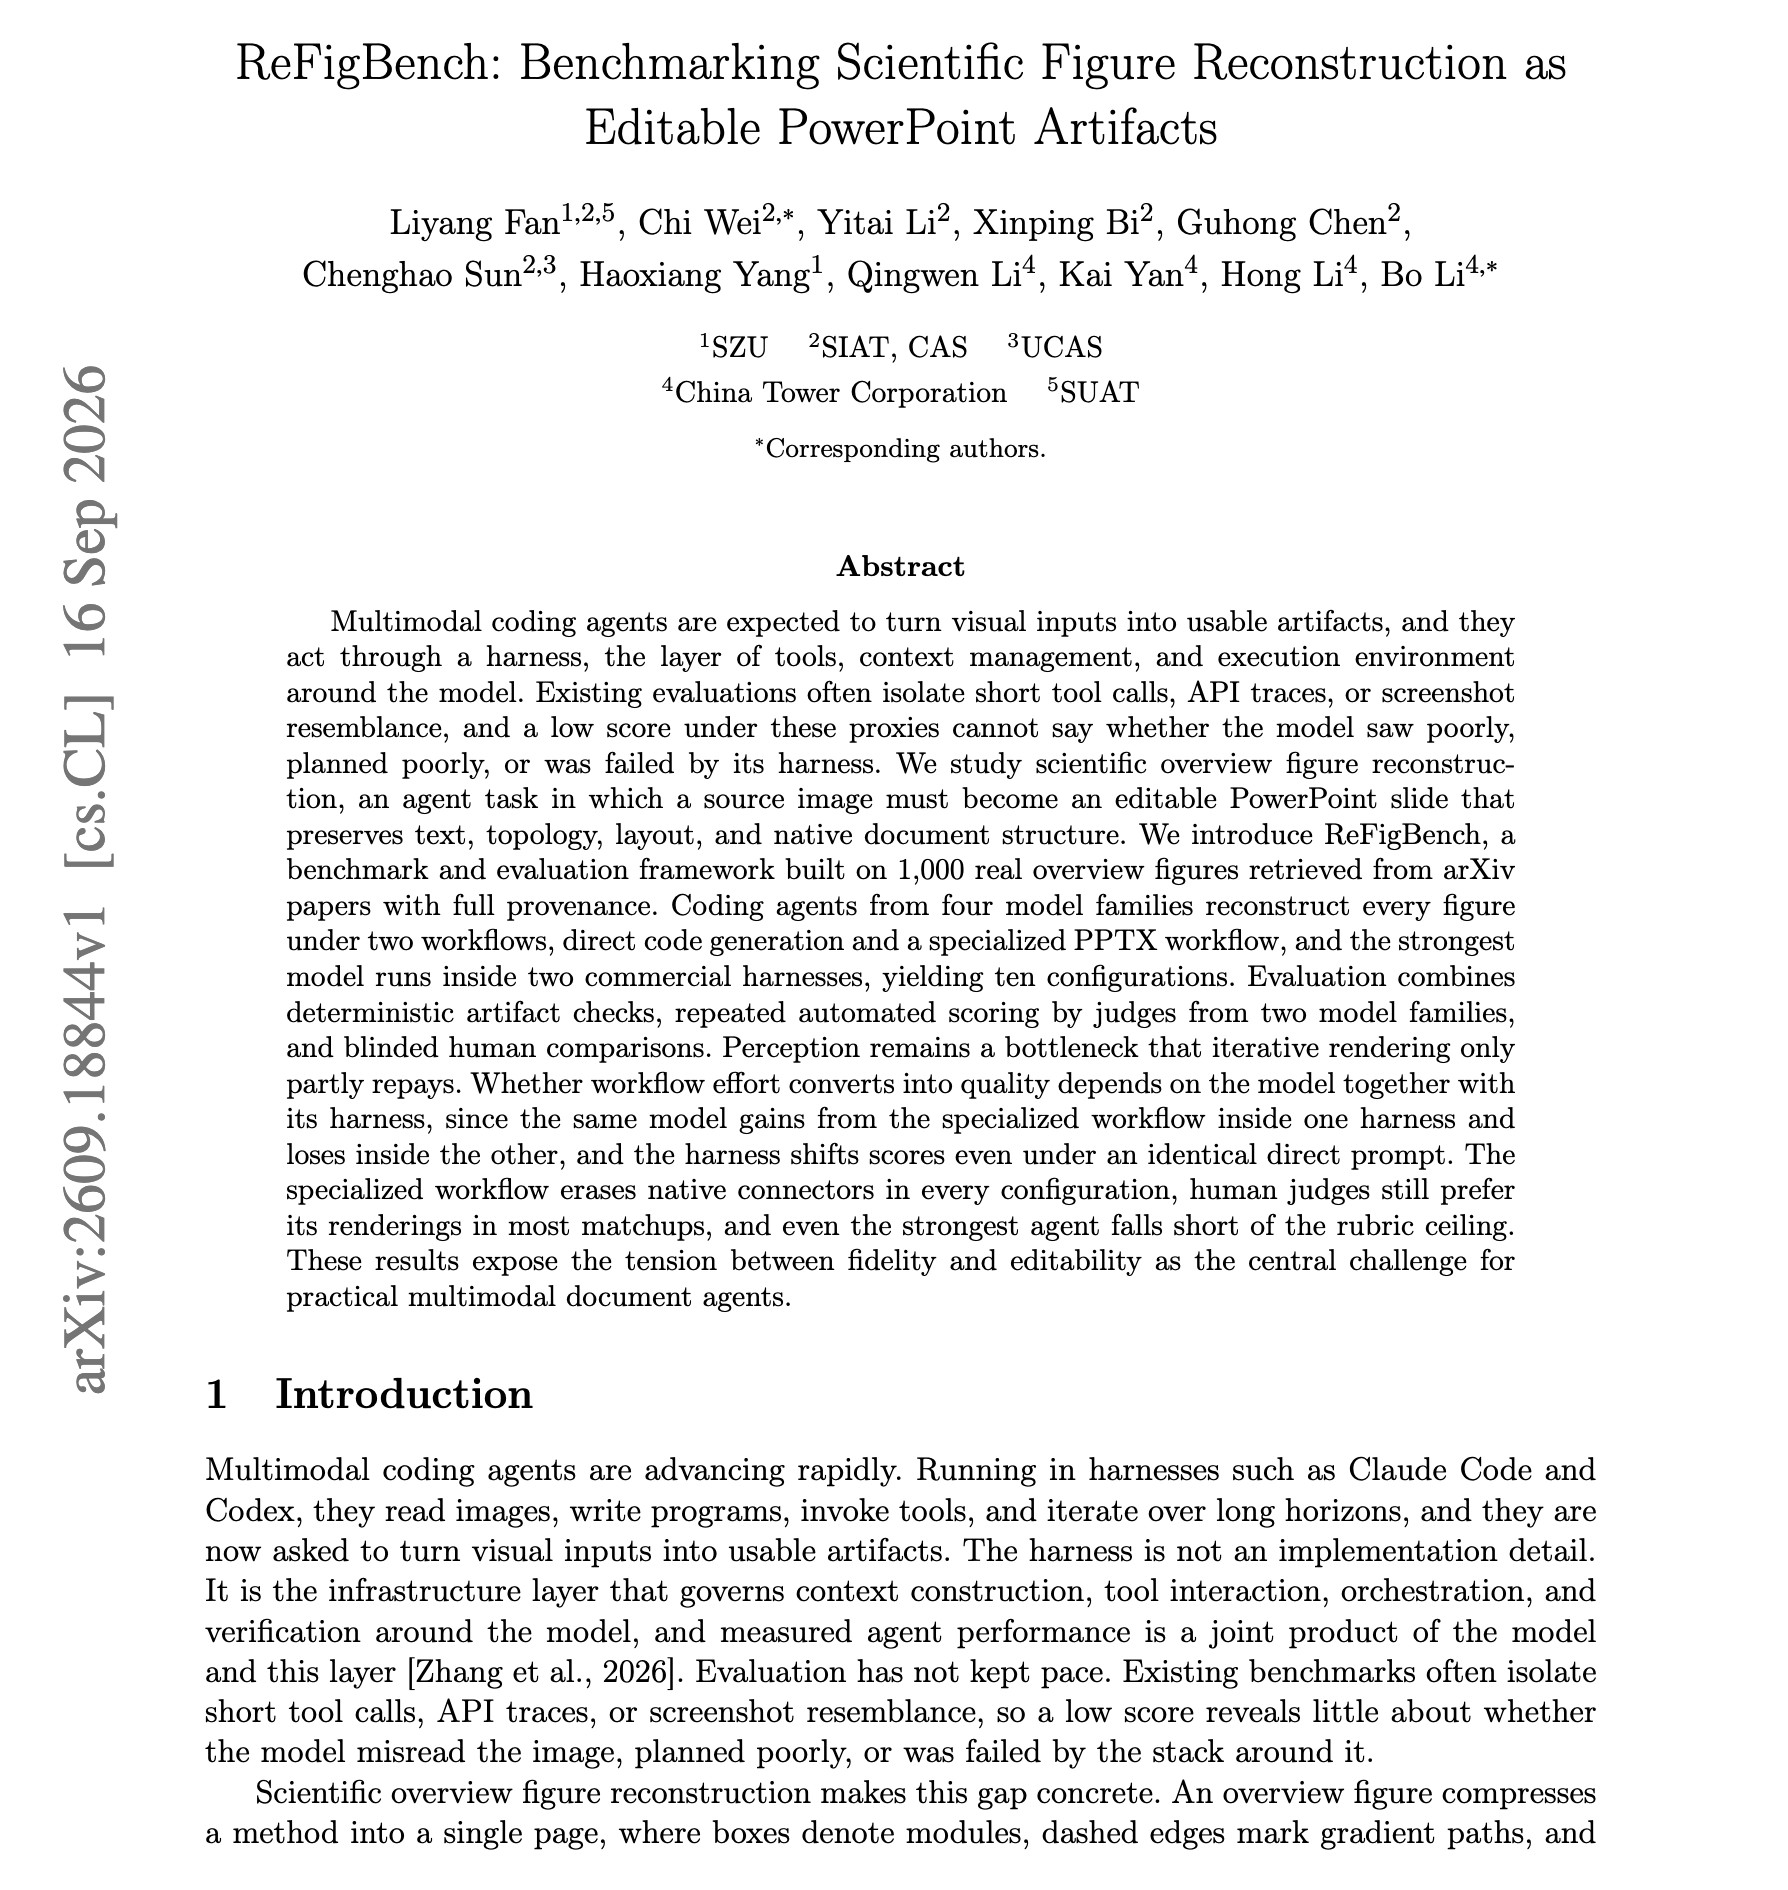
要点:@omarsar0 转发 ReFigBench:同一模型(含 GPT-5.5)在 Claude Code vs Codex 等不同 harness、同一 prompt 下分数可反向;专门 PowerPoint 工作流会在一个 harness 里变好、在另一个里变差——再证「模型榜 ≠ 你装的代理」。同日 DigitalOcean Managed Agents 主打托管 Claude Code / Codex 等 harness,把闲置 CPU 与 16k+ tools 外包掉;@zachlloydtweets 则把「多模型 + 多 harness + 数据所有权」写成软件工厂三件套。
为何值得看:双巨头同日换模时,社区把镜头对准「壳」而不是只刷参数。
- ReFigBench:https://x.com/omarsar0/status/2102485592420606054
- Managed Agents:https://x.com/omarsar0/status/2102430254535233981
- 工厂三件套:https://x.com/zachlloydtweets/status/2102427795167322507
8. Factory / Capy:Opus 5.5 进 Droid,PR 速度对比 Codex / Claude Code
要点:@FactoryAI 称 Opus 5.5 已在 Factory 可用:Medium 是强默认,同 effort 下输出 token 约少 20–25%,长调查更敢给可执行结论。@garrytan 则点名 Capy:比单用 Codex 或 Claude Code 更能「更快甩出 PR」。
为何值得看:新模型落地的另一条线——垂直软件工厂 / PR 工作流,在比「少说话、多合码」。
- Factory:https://x.com/FactoryAI/status/2102439895109370349
- Capy:https://x.com/garrytan/status/2102544711647129902
9. Jev:决策模型周——从获客到 Gateway / LangSmith / Spring
要点:Jev 热度未退。@vovudebosh 惊呼它能「读网站 → 找潜客 → 发邮件约会议」。@rauchg 称 AI Gateway 可用 HTTP 调 TypeSafe Jev;@openclaw 写 decision model 进核心与插件;@hwchase17 改进 LangSmith 上的 Jev UI;@starbuxman 写 Spring AI + TypeSafe Jev 做便宜结构化决策。@mitsuhiko 则吐槽命名:到底叫 classification 还是 decision。
为何值得看:讨论从「零样本分类器好玩」扩到「嵌进网关 / agent 编排后的默认组件」。
- 获客场景:https://x.com/vovudebosh/status/2102303268261237131
- AI Gateway:https://x.com/rauchg/status/2102205684544852121
- OpenClaw:https://x.com/openclaw/status/2102488199486656862
- LangSmith UI:https://x.com/hwchase17/status/2102470464735949263
- Spring AI:https://x.com/starbuxman/status/2102402686612058486
10. Cline 换新形象;顺带一眼 Kimi 浏览器扩展
要点:@cline 为两岁的开源 coding agent 换了全新吉祥物与视觉——从 hackathon 图标升级到「上百万台设备」后的品牌感。同日 @Kimi_Moonshot 把原 WebBridge 升级为 Kimi Browser Extension(侧栏导航、填表、操作网页),并宣称 Kimi K3 已上 Amazon Bedrock,方便 coding / 长 agent 工作流走企业通道。
为何值得看:一边是开源 harness 开始认真做品牌,一边是国产模型继续往「浏览器侧 agent + 云托管」铺货。
- Cline 新视觉:https://x.com/cline/status/2102508032873943330
- Kimi 扩展:https://x.com/Kimi_Moonshot/status/2102372557190230244
- K3 on Bedrock:https://x.com/Kimi_Moonshot/status/2102244258531213596