AI Twitter/X 热点 Digest · 2026-11-20(周五)
今日要点
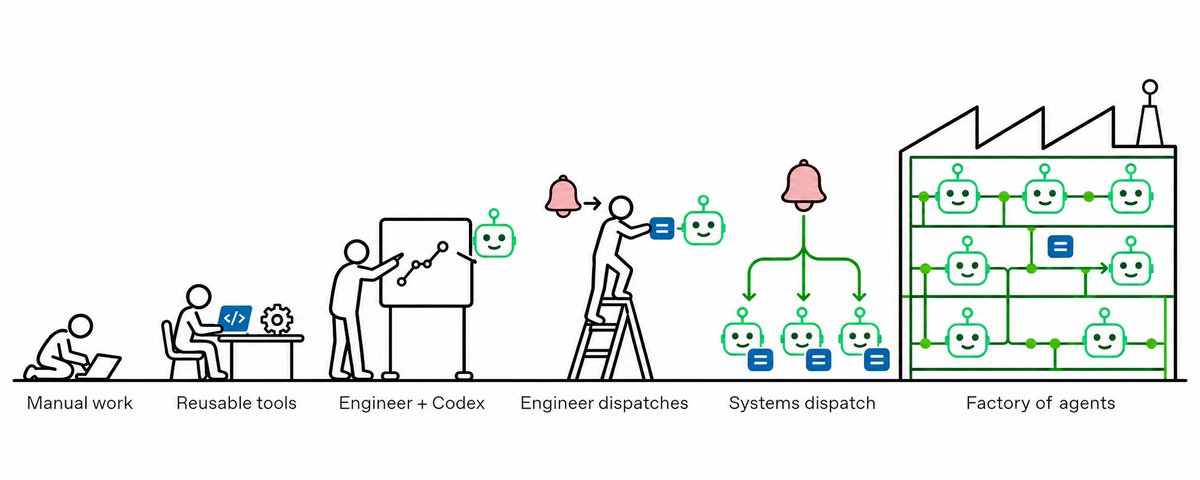
- OpenAI Performance Factory:性能告警触发 Codex 调查,另一会话尝试推翻归因,工程师审补丁、线上指标验收。
- Replit Missions:Replit 公开了按预算组队的案例;NumPy 实验从 16 到 32 个 agent,程序加速从 17× 到 19×。
- Gemini 4 Neon:Cognition、Vals AI 和 Artificial Analysis 的跟进都给了性价比信号,但测的不是同一件事。
1. 线上性能回退:Codex 做归因,工程师审补丁
要点:OpenAI 把线上指标异常接进持续运行的 Codex 工作流。检测到回退后,调查会对照指标、版本和代码变更定位原因;有足够证据时再起草补丁,由工程师审阅,上线后继续核对性能指标。官方说三个多月追踪了 1,700 多次调查、为 600 多个案例定位了根因。这不是 600 次修复,更不是自动合并的数量。 这套系统不是让一个 agent 从头写到尾。任务状态保存在工作流之外;独立 Codex 会话尝试推翻归因,比如检查没有接触新版本的请求是否也变慢。只有归因经得住反证,才会生成修复 PR;如果上线后指标没恢复,任务回到调查。
为何值得看:最值得借鉴的是验收信号来自线上指标,而不是 agent 自报成功。把检测、归因、审阅和上线复核拆开,也能看清自动化到底省掉了哪一环。
2. Replit Missions 让 agent 按目标和预算组队,但代理翻倍不等于收益翻倍
要点:Replit 继续公开 Missions 的多 agent 案例。用户给目标、约束和预算,Missions 自行拆任务并检查结果。官方博文用 13 个 NumPy 优化任务举例:Auto (Max) 下,单 agent 的优化最高约 4×,16 个达 17×,32 个达 19×。研究跟帖强调任务归属清楚、共享发现以及降低协调开销。这里的倍数是优化后的程序性能,不是做任务的速度,也不是所有 GitHub 项目的平均收益。
为何值得看:从 16 到 32 是值得看的一段:多一倍 agent 只多出一截最优结果。对要做多 agent 的团队,这比「最多 32 个」更实用。先找能并行又能客观验收的任务,再看多开一次是否值那个成本。
3. Neon 发完后的第二问:在哪个评测、花多少钱,追上了谁?
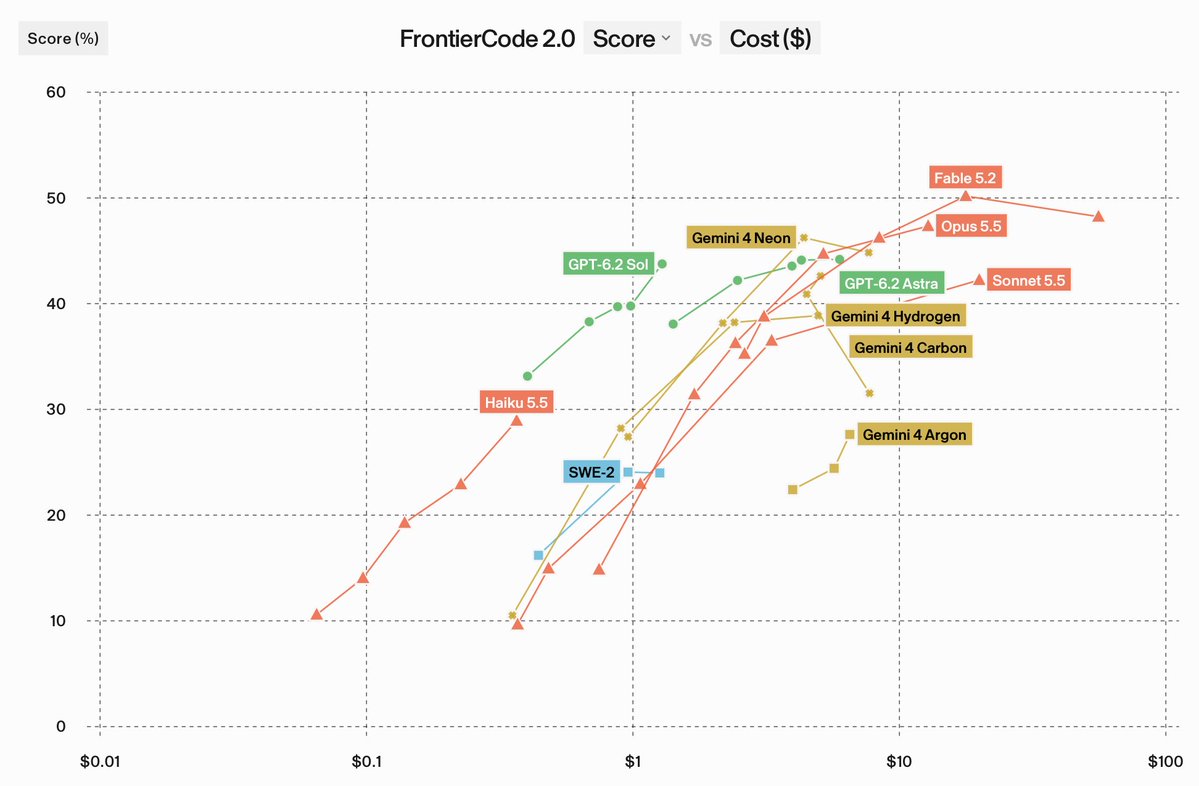
要点:接着 067 期的发布,Cognition 在 FrontierCode 2.0 上报 46.2%,距 Opus 5.5 不到 1 个百分点,约三分之一的任务成本。Vals AI 报的是另一套 RSI Index:Neon 排第 4,跑完整套约 $475,Fable 5.2 和 Opus 5.5 分别约 $1,536 和 $1,647。Artificial Analysis 比的是 Gemini 4 家族,在自己测的档位里,Neon 和 Hydrogen 占据智能对任务成本、耗时的前沿。
为何值得看:三个结果指向相近的性价比信号,但「PR 值不值得合」「RSI 表现」和「通用智能对成本」不能合成一张榜。做 IDE 默认路由,应该在自己的任务分布里复测 Neon,而不是直接拿三分之一作预算假设。
- Cognition:FrontierCode 2.0
- Vals AI:RSI 排名
- Vals AI:全量运行成本
- Artificial Analysis:Gemini 家族对照
- Artificial Analysis:成本与耗时前沿
- FrontierCode 榜单
4. Codex CLI 0.171.0:终端工作区默认打开,非交互任务也能连远程
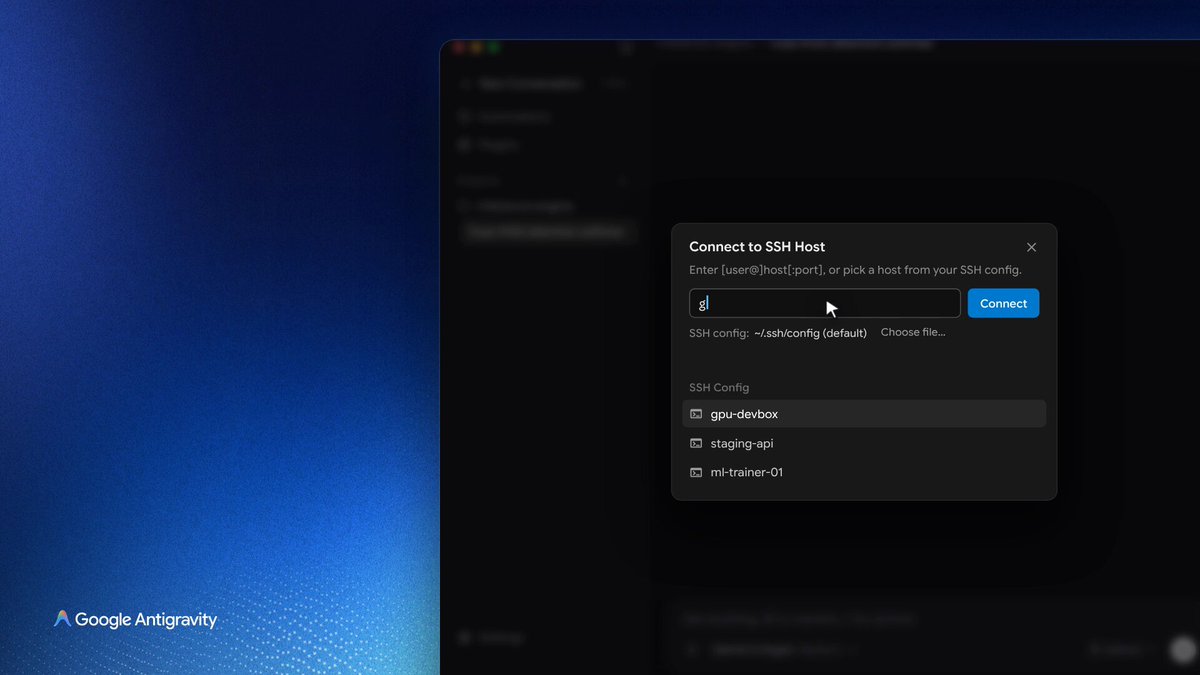
要点:预览文档、图片和子代理 transcript 可以留在终端会话旁。新版支持用 codex exec --remote <ADDR> 在已有的 app server 上启动或恢复非交互会话;GPT‑6.2 Sol 和 Astra 同时加入模型目录,默认选 Sol。这里的远程是连接一个已经运行的服务,不会自动开机器。 同一窗口,Antigravity 官方宣布桌面端已经能通过 SSH 连接远程服务器。两件事不是一回事:Antigravity 给桌面交互增加远程入口,Codex 则新增脚本任务连接已有会话服务的入口。
为何值得看:这比新增一个窗口更值得看:交互式会话和脚本任务都有了连接远程会话服务的入口。评估自己的远程 harness 时,可以分别看会话恢复、授权和草稿是否留在原线程。
5. Perplexity 让技能从旧任务里学习,GUARD 提醒先防回归
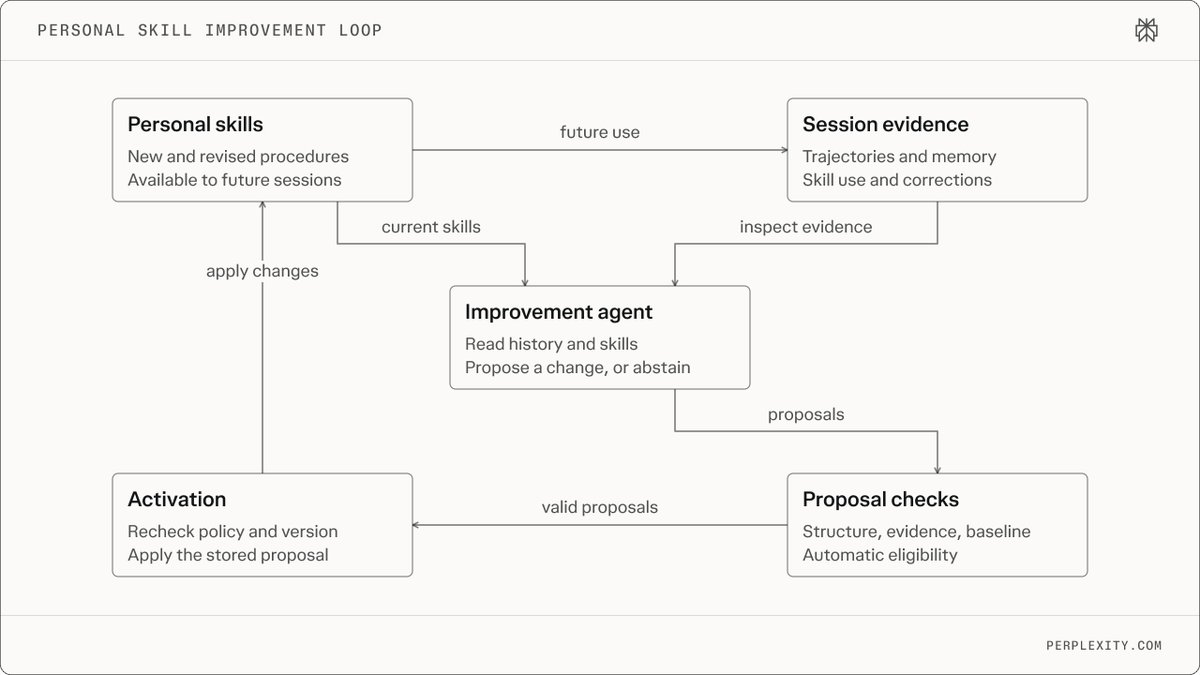
要点:Perplexity 在 X 展示 Computer 的 Brain:一个任务完成后,另一个过程读取轨迹,提炼可复用内容到私人技能,用户可选启用。官方披露的小样本 SkillLearnBench 有 16 个配对案例,成功率从 43.8% 到 62.5%。同一窗口流传的 GUARD 论文讨论相反的一面:模型冻结,让 harness 接受可验证的新修改,同时用保留样例检查原先会做的任务有没有被改坏。
为何值得看:把轨迹写进 skill 不难,难的是阻止一次偶然成功变成永久规则。小样本不是普遍收益;而 GUARD 的防回归只覆盖纳入检查的任务。工程上可以先让 agent 提议修改,再用固定样例做接受门槛。
6. Harness Hub 给 Hermes 单独训练 LoRA:别只比模型,也要看跑在哪个 harness
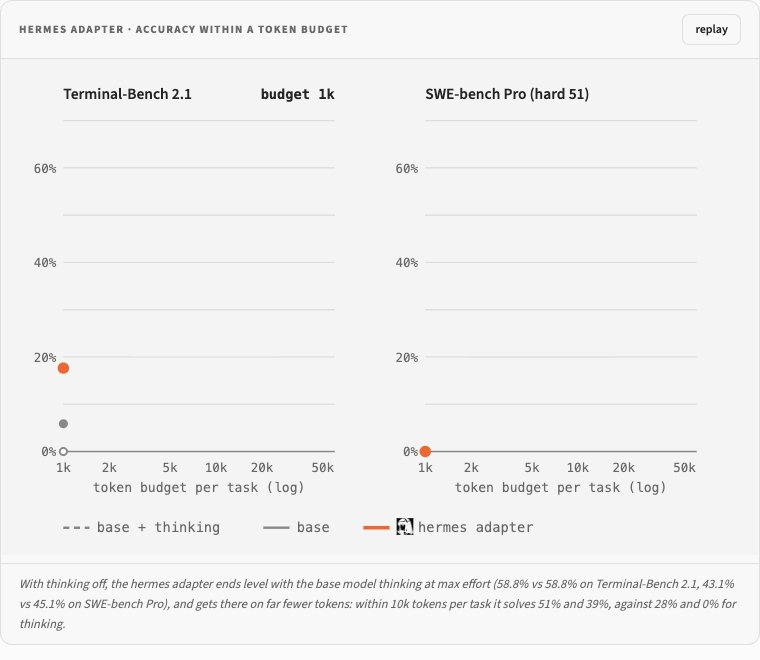
要点:团队在 X 公布面向 Hermes 的 Qwen3.8-27B 适配结果。模型卡上,在同一个 Hermes harness 内,关闭 thinking 时,SWE-bench Pro 的 51 道困难题从 29.4% 提到 43.1%,Terminal-Bench 2.1 从 44.7% 提到 58.8%。原版开 xhigh 在后者也是 58.8%,适配版的部分对照任务生成 token 更少。社区有人在 Pi 上试了一道自己的任务,也有人转述 OpenCode 的评测。两者都不是对 Hermes 成绩的独立复测。
为何值得看:值得测的是模型和 harness 的搭配有没有降低每个成功任务的成本。不同 harness、不同难题子集不能混成一张排行榜。也不要把 LoRA 的收益误算成 Hermes 本身的收益。
7. Gemini API 和 LangSmith 都开始按需加载工具,但控制点不同
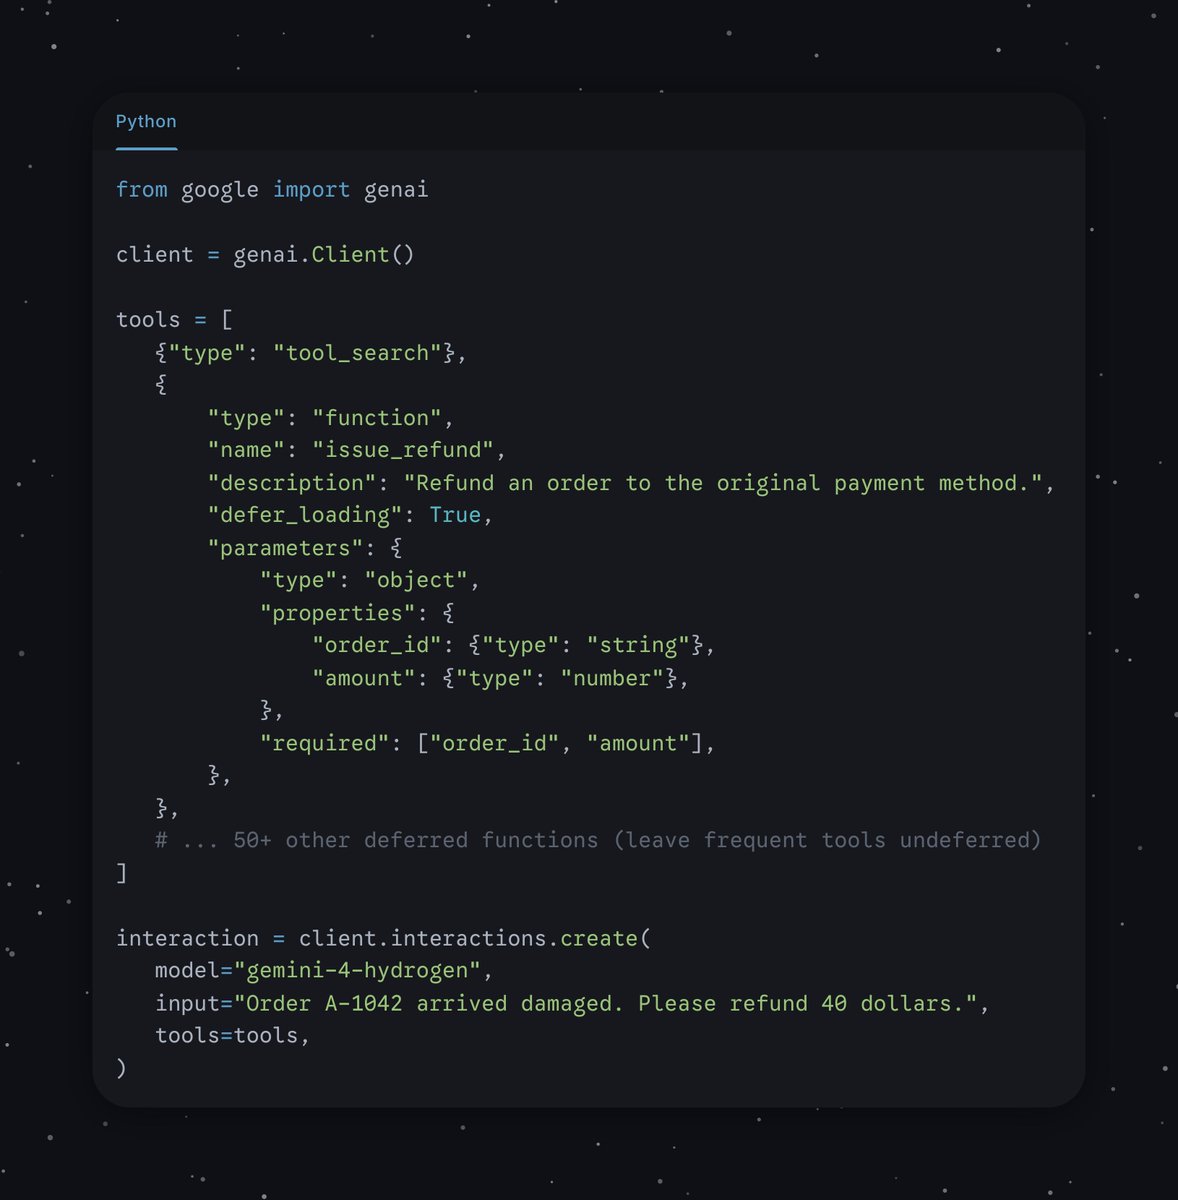
要点:Google 在 Gemini Interactions API 加入 Tool Retrieval:先给模型名字和描述,通过 tool_search 再取相关工具的参数结构,而不是一开始塞进全部 schema。Google 表示 Gemini 3.6 及更新版本支持。LangSmith 同期公测 Tool Gateway,把工具打包为一个 MCP 地址,Search Mode 按需发现;授权身份、工具级权限与调用记录则留在网关。Harrison Chase 的发布帖特别强调用谁的身份调用。
为何值得看:发现和授权应该分开看。前者主要影响上下文和工具选择,后者决定什么操作能以谁的身份执行。模型知道工具存在,不代表它已经获准调用;接入大工具集时应该分别量这两层。
- Google Developers 发布帖
- Harrison Chase 谈调用身份
- Harrison Chase 发布周总览
- Google Tool Retrieval 说明
- LangSmith 网关说明
8. GPT‑6.2 跨轮 reasoning:编辑历史和追加消息不是一回事
要点:OpenAI 文档说明:在 Responses API 中,如果客户端插入或改写某个已保存 reasoning item 之前的内容,该 item 可能因 prefix_mismatch 被丢弃。仅在其后追加内容,不会触发这条规则;删除整项且不改其余项不单独触发这一原因。服务端会在响应的 input_transformations 中说明变换。 另一个同期讨论是 Peter Steinberger 说 OpenClaw 的内嵌 harness 合入了缓存修复。它对应开发者报告的另一个缓存现象,不能拿这条回复当作 OpenAI 修好了 API,也不能把单客户端命中率当通用数值。
为何值得看:如果 harness 会插系统提示、压缩或改写旧输入,别把「客户端把 reasoning 原样传回」当成「服务端一定保留」。直接记录返回的转换原因,才能区分状态丢失和模型本身的差异。
- OpenAI API reasoning 文档
- OpenAI Developers 原帖
- OpenAI 诊断方法
- OpenAI 对追加内容的说明
- Peter Steinberger 关于 OpenClaw 的回应
- 开发者报告
9. Vercel Board:把人和不同工具的 agent 放进同一条任务线程
要点:Vercel Board 已向所有套餐开放,仍是实验功能。人和 agent 可以在频道中开任务线程,由 agent 认领、回报进度并附上 PR。自建 harness 可通过 CLI 或 JavaScript SDK 接入;Vercel Connect 支持与 Slack、GitHub 双向同步,访问范围可以按人或 agent 设置。 Rauch 把它放在多代理软件工厂的语境里。Box 的 Aaron Levie 则从行业层面看,指出交互正从问答变成编排任务。这是产品方向判断,不是对 Board 使用成效的评估。 设计上也可以和 Amp Spaces 对照。Amp 的 Thorsten Ball 说用户反应分成两派:有人正想要这个,有人不明白是否只有多人使用才值得开。这是两个不同产品,但都暴露了同一个采用问题:新协作界面得先讲清楚单人用有什么好处。
为何值得看:Board 把任务状态放在独立于模型和执行器的线程里。这个方向值得看,但「多个 agent 能加入」不等于它已经解决了重复认领、权限冲突或者失败重试。
10. Claude Code 2.1.329:审查范围和后台任务变得更明确
要点:多数模型在不带目标运行 /code-review 时,会将整个分支和默认分支比较,而不仅检查未提交改动。给 PR 编号时,工具现在用 gh pr diff 获取目标,拿不到会说明,不再默默审本地分支。/tasks 新增当前会话的定时任务、/loop 唤醒、goal 和会话 forks。Code Mode 也支持按工具调用发送 OpenTelemetry 事件;启用 tracing 仍会关掉 Code Mode。 另一个修复容易漏掉:已连接的 MCP 服务如果加载工具失败,现在会把失败告知模型,不会让它误以为服务本来没有工具。
为何值得看:一个审错目标的 code review 再详尽也没有用。这里值得抄的是目标解析失败就显式报告,以及把会话派生出来的后台工作都放回同一个可检查的任务视图。