AI Twitter/X 热点 Digest · 2026-10-30(周五)
今日要点
- 订阅与 API 同时松绑:Codex 侧兑现昨日「好消息」——Pro 全档与 Business Premium 额度翻倍,并撤回 Pro 200 降额;Anthropic 则把 Claude API 单次请求上限扩到 128 MB,给长 computer-use 与大 PDF 腾空间。
- 开源权重与评测并行:Mistral Large 4(Le Chonk)正式放权重;Artificial Analysis 同日补 HLE-Diamond 榜与 Search Index,把「难题」和「给 agent 选搜索 API」都产品化。
- 人怎么驾驭 agent 成了方法论主线:Thariq 谈 coding agent 狂热式逃避;Mainplane 用数据打 Compaction;Jules 宣布收尾、经验并入 Antigravity——工具在换,习惯也在被重写。
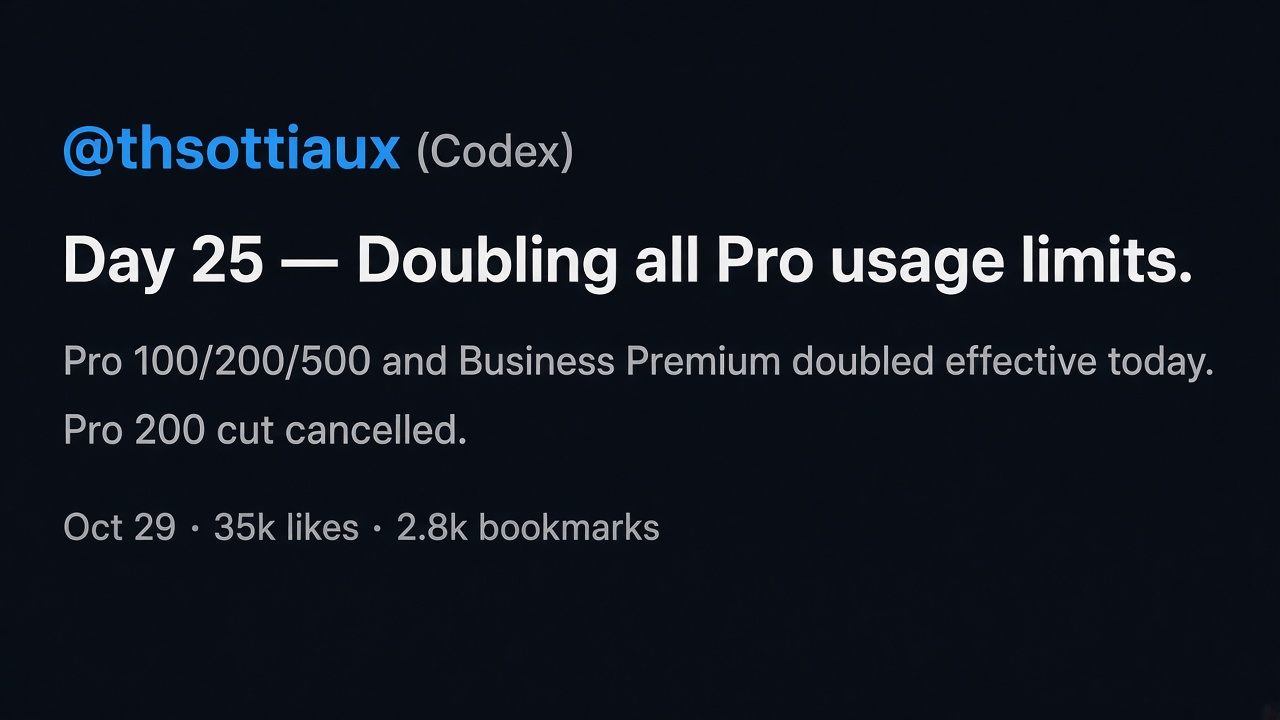
1. Codex Day 25:Pro 全档额度翻倍,Pro 200 降额取消
要点:@thsottiaux(Codex)发布 Day 25:即日起 Pro 100 / 200 / 500 与 Business Premium 所有用量上限翻倍;此前预告的 Pro 200 降额取消,Work 与 Codex 额度保持不变;dot 的 extended limits 暂续,且与默认用量分开计算。@dotey 同步中文解读:Plus 不在名单,价格未上调。
为何值得看:这是对 10-29「明天有好消息」悬念的兑现,也直接回应社区对老 Pro 200 收紧的焦虑——额度叙事从「扣」改成「加倍 + 不降」,短期算力焦虑明显降温。
- thsottiaux:Day 25 官宣:https://x.com/thsottiaux/status/2115850175868727621
- dotey:中文摘要(含各档推算):https://x.com/dotey/status/2115856411439575386
2. Claude API:单次请求 32 MB → 128 MB
要点:@ClaudeDevs 宣布 Messages 与 Token Counting 接口的 单次请求体积上限 从 32 MB 提到 128 MB(约 4×)。动机写得很具体:长 computer-use 截图会话、大 PDF 往往在上下文窗口还没满时就先撞上 32 MB。@dotey 强调:仅限 Anthropic 官方 API。
为何值得看:这不是「再开一点上下文窗口」的宣传,而是把多模态 / 工具轨迹的载荷上限当成产品瓶颈来修——谁在跑长截图 agent,谁先感知到这次扩容。
- ClaudeDevs:官宣:https://x.com/ClaudeDevs/status/2115923971279614171
- dotey:中文说明:https://x.com/dotey/status/2115968852349567254
3. Thariq:coding agent 狂热往往是一种逃避
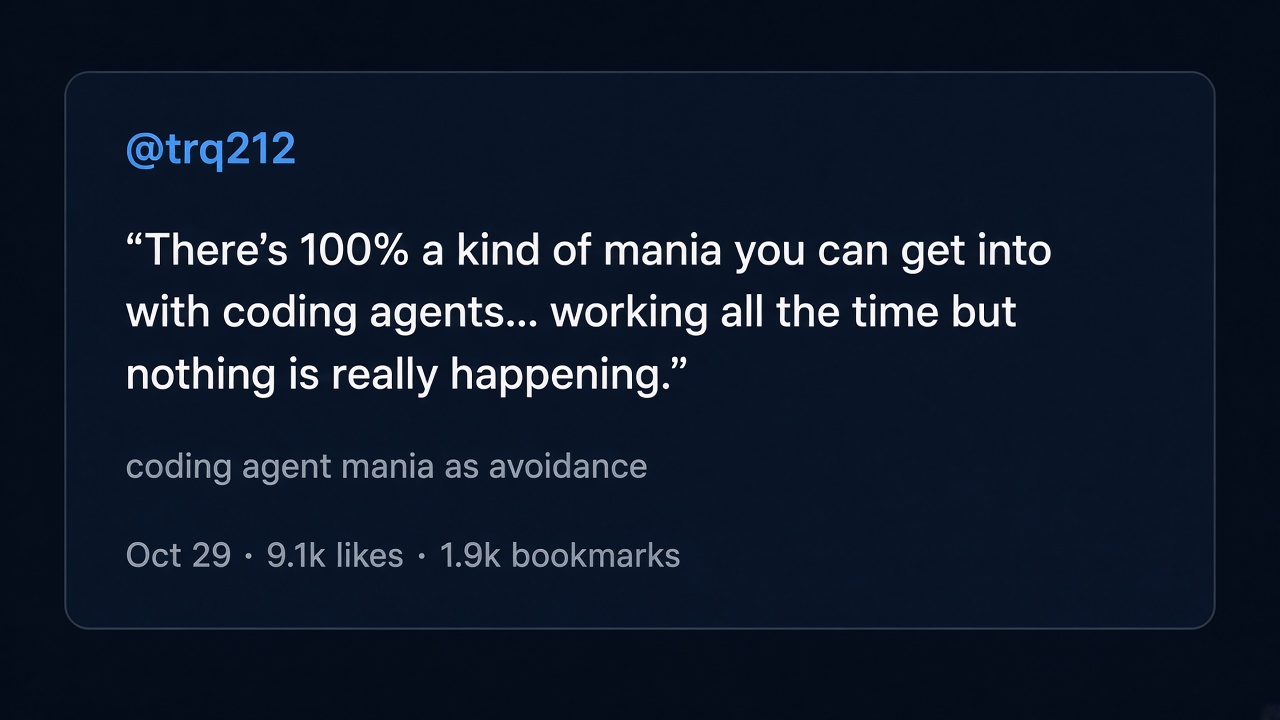
要点:Anthropic 的 @trq212(Thariq)写道:跟 coding agent 一起工作时,很容易进入一种 mania——感觉自己一直在干活、一直在推进,但其实什么实质结果都没有;他判断这常常是在逃避生活里别的事。该帖点赞破九千、收藏近两千,讨论区迅速分成「说中了我」与「这是正常探索期」两派。
为何值得看:模型与额度都在涨的当天,一线产品人把镜头对准使用者心理——提醒「吞吐感 ≠ 交付」,比又一张榜单更能校正日常用法。
- trq212:原文:https://x.com/trq212/status/2115937378674372783
4. Mistral Large 4(Le Chonk):开源权重上线
要点:@MistralAI 宣布放出改进版 Le Chonk 权重,主打 agentic coding 与网络安全;称在 @cognition FrontierCode 开源模型中排第一,并强调 CrowdStrike / Cloudflare 等厂商侧的防御评测。@ArtificialAnlys 跟帖核实:Large 4 现为中国以外开源权重第一(约 1.05T total / 52B active);Coding Agent Index(在 Mistral Vibe)约 48,位列当前开源第二梯队并强调更省 token。权重可在 Hugging Face 下载;许可为 modified MIT(MaaS 需另获商用许可)——「开源权重」已核实,不是传闻。
为何值得看:闭源侧刚刷过 Carbon / Fusion 的第二天,欧洲开源旗舰用「放权重 + 少 token」抢主权与自托管叙事;评测机构同屏对账,比单方官网截图更可信。
- MistralAI:放权重官宣:https://x.com/MistralAI/status/2115811242556137820
- ArtificialAnlys:开源权重榜解读:https://x.com/ArtificialAnlys/status/2115820547103952925
- ArtificialAnlys:Coding Agent Index:https://x.com/ArtificialAnlys/status/2115820551675789731
5. OpenCode Go Teams:整队可用,约 20 美元/人/月
要点:@opencode 宣布 OpenCode Go 现可开给整支团队;产品页写明 Go 10 美元/月、Go Plus 40 美元/月、Go Teams 20 美元/成员/月,并配演示视频。定位是「低成本拿到主流 coding 模型」的团队入口,而不是又一个单人 CLI。
为何值得看:个人档打完价格战后,下一场是席位制——谁能把「每人一份额度」做成默认采购单元,谁就更接近企业试用清单。
- opencode:Go Teams 官宣:https://x.com/opencode/status/2115898662622462126
6. Anthropic:Claude「自我评估」防滥用
要点:@AnthropicAI 介绍 self-assessment:Claude 在每次回复后,对整段对话做一次初步安全评估;自 6 月启用以来,抓到过其他防护没覆盖的滥用。因为模型已读过对话,额外成本低;且不像离散分类器,会随模型变强而变准。@dotey 补充中文要点:算力由 Anthropic 承担、不向用户收费、不额外收集数据,并称单条标记不会直接导致封号。
为何值得看:安全侧从「外挂分类器」走向「模型自审」——对重度 coding / agent 用户,这意味着更多后台检查发生在你看不见的回合间隙,也解释了为何官方反复强调「不算你的钱」。
- AnthropicAI:官宣:https://x.com/AnthropicAI/status/2115871889549865429
- dotey:中文摘要:https://x.com/dotey/status/2115923359149998490
7. Jules 收尾:经验并入 Antigravity
要点:@julesagent 回顾 Jules 作为异步 coding agent 实验的收获,并称这些学习已影响 Google 多条产品线;接下来会把 Jules 的经验带入 @antigravity,目标是同时保留「远端自主后台任务」与「agent-first 开发环境」。随着精力集中到统一体验,Jules 将逐步收尾(winding down)。帖中未给出具体关停日,社区情绪两极:怀念「异步修 bug」与期待 Antigravity 合体。
为何值得看:这是平台把实验品牌收回主产品线的典型动作——异步 agent 不再当独立 App 养,而是变成 IDE / 远程任务的一组能力;选型时别再把 Jules 当长期独立路线。
- julesagent:收尾说明:https://x.com/julesagent/status/2115883717705261283
8. Artificial Analysis:HLE-Diamond 榜上线
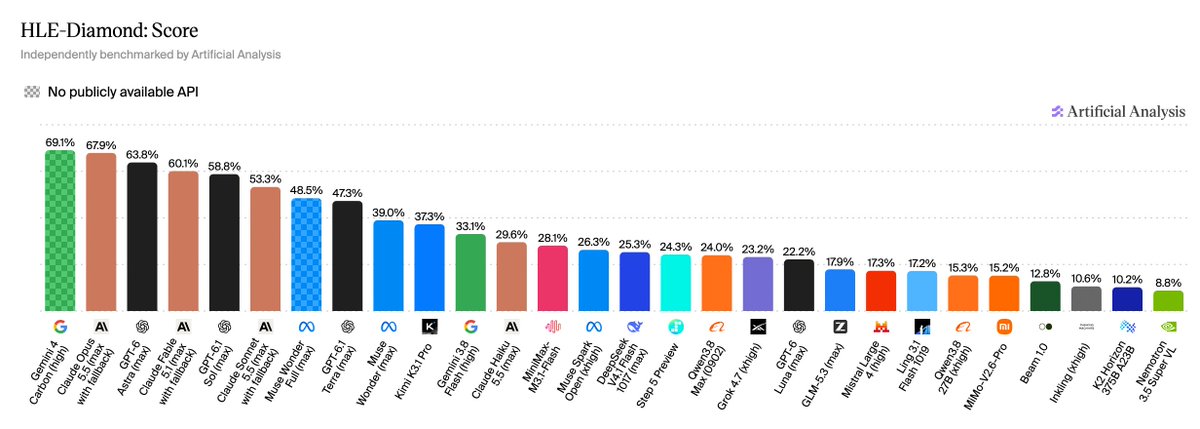
要点:@ArtificialAnlys 发布 HLE-Diamond 独立评测榜(作为 Intelligence Index v5 一部分)——基于 CAIS / Scale AI 精修后的 1000 题 Humanity’s Last Exam(推理/知识各半,272 题含图)。规则:无工具、官方 system prompt、用 GPT-5.6 Luna(medium)按官方 judge prompt 判对错(pass@1)。要点:仅约 13% 变体超过 50%;Gemini 4 Carbon (high) 69% 领先,Claude Opus 5.5 (max) 68%;模型普遍推理强于知识;开源权重落后闭源 30+ 分。跟帖还给出 effort 开关:Opus 5.5 low→max 可涨约 26 分、成本约 35×。
为何值得看:在 Index v5「私有题库占多数」之后,HLE-Diamond 把「人类终极考」收成可复现的独立板——Carbon 与 Opus 再次贴身,开源侧差距则被量化得很难用营销话术抹平。
- ArtificialAnlys:HLE-Diamond 官宣:https://x.com/ArtificialAnlys/status/2115989388689813945
- ArtificialAnlys:effort / 成本跟帖:https://x.com/ArtificialAnlys/status/2115989392695374188
9. Compaction 之争:摘要压缩 vs 按需检索
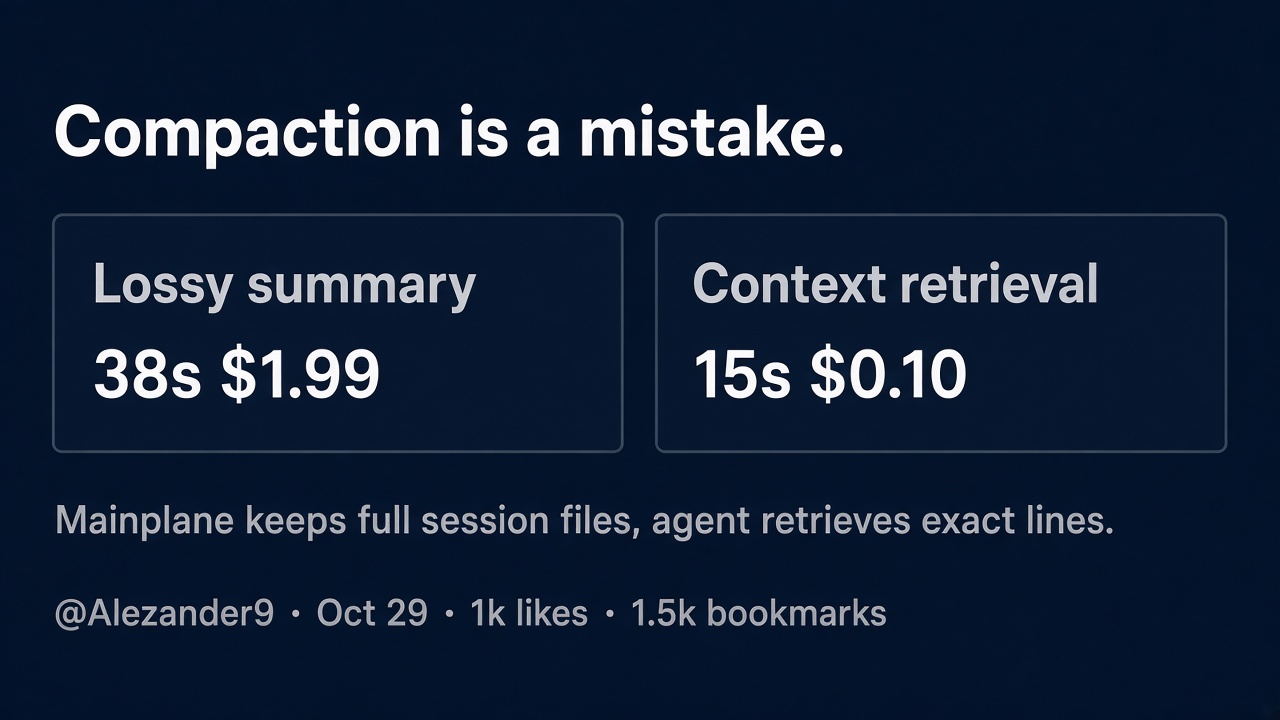
要点:@Alezander9 发长文称 「Compaction is a mistake」:Codex / Claude Code 在上下文满时会重填会话、写摘要、再开新会话;他在约 40 万 token 的真实 Opus 5.5 会话上测得——缓存过期时约 38 秒 / 1.99 美元,命中缓存约 29 秒 / 0.17 美元,且摘要有损。Mainplane 做法相反:完整会话落盘,新会话立刻开始并指令「按需检索旧会话」;同场景约 15 秒 / 0.10 美元,不依赖缓存命中。Mainplane 自称 MIT 开源。该帖收藏(约 1564)显著高于点赞,偏「方法论存档」;@dotey 随后讨论 Claude Code 压缩后按需回读与 Mainplane 差异。
为何值得看:长会话的真正成本不只是 token 标价,而是「摘要丢了哪一行关键」——把记忆从「模型总结」改成「工具检索」,是 agent harness 层正在发生的 bitter lesson 实践。
- Alezander9:长文:https://x.com/Alezander9/status/2115842962521509968
- dotey:与 Claude Code 压缩的对比讨论:https://x.com/dotey/status/2116026448234332315
10. Artificial Analysis Search Index:给 agent 选搜索 API
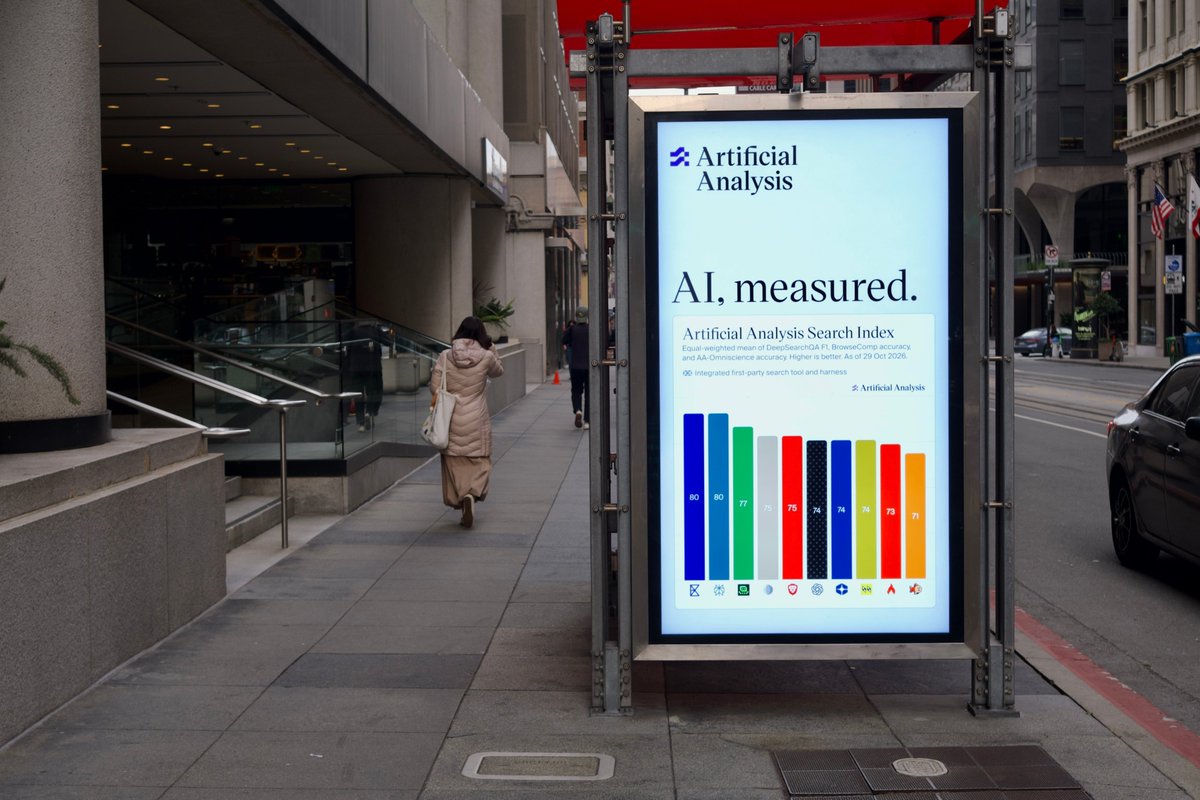
要点:@ArtificialAnlys 推出 Search Index:在同一基座模型与 harness 下,用约 1700 个任务与 BrowseComp / DeepSearchQA / AA-Omniscience 三个搜索基准,衡量各 Search API 的效果、成本与延迟。官方判断:年底前 agent 搜网量可能超过人类;当前 Exa (auto) 与 Perplexity (medium) 以其最佳配置并列领先(约 80 分)。
为何值得看:coding agent 之外,「搜什么、用哪家 API」正在变成可比较的基础设施选型——Search Index 把营销页上的「更懂搜索」拉回同一张板。
- ArtificialAnlys:Search Index 官宣:https://x.com/ArtificialAnlys/status/2115970517778002283