AI Twitter 热点 · 2026-10-07
AI Twitter/X 热点 Digest · 2026-10-07(周三)
今日要点
- Anthropic 和 Mistral 抢走头条:Claude 直接进入 Google Docs / Sheets / Slides 侧边栏(2.2 万赞),Claude Startups 计划扩容,Cyber Verification Program 也开放了渗透测试等授权攻击类用途;Mistral 发布 1T 总参 / 49B 激活的 Mistral Large 4,今天只有 API,开放权重要到 10 月底。
- OpenAI 双线出货:Codex「28 天」Day 2 一口气给了四项:Auto-review 免费且不占用量、API 用量档位简化、会议纪要插件、Decisions API 公测;同晚 OpenAI 公开内部前沿模型产出的 722 篇数学稿件。
- 工具链在补「基础设施」:Mitchell Hashimoto 发布终端程序状态规范 OSC 7501,想终结 250 多个 agent 编排器各自猜「Claude Code 是不是卡住了」的局面;Armin Ronacher 写长文解释 Pi 1.0 用 Codemode 接 MCP 的思路;thdxr「模型进步快过折腾者」一帖破万赞。
1. Anthropic:Claude 进 Google Workspace,Startups 扩容,Cyber 计划放宽
要点:@claudeai 宣布 Claude 可以直接在 Google Docs、Sheets、Slides 里工作:以侧边栏形式读取当前打开的文件并就地编辑,每处修改都可以先审批再落地;反过来这些文件也能在 Claude 里打开。这条拿下 2.2 万赞、6000 多收藏,是今天最热的 AI 帖。同一天 Claude Startups 计划扩容:成员可获得一年 Claude Team、API credits、常用工具优惠和 Anthropic Applied AI 团队的 office hours,近五年成立或近两年融资的初创公司可申请(收藏 9500,比点赞还高)。@AnthropicAI 还扩大了 Cyber Verification Program:经验证的安全从业者可使用 Claude Mythos 5.1、Opus 5.5、Sonnet 5.5,并新增允许渗透测试、红队等授权攻击类工作的档位。另外 Every 团队分享了他们在 Claude Managed Agents 上搭建、全员在 Slack 里用的公司 agent。
为何值得看:Claude 从聊天窗口和终端走进办公文档主战场,并且采用「逐条审批」的编辑模式;Cyber 计划放开攻击类用途,则是在回应「前沿模型安全任务拒答太多」的抱怨(见下一条 Cline 的测评)。
- Claude for Google Workspace:https://x.com/claudeai/status/2107522596845822135
- Claude Startups 扩容:https://x.com/claudeai/status/2107513494493179954
- 申请条件与活动:https://x.com/claudeai/status/2107513501576999318
- Cyber Verification Program:https://x.com/AnthropicAI/status/2107546569654636883
- Every 的公司 agent:https://x.com/claudeai/status/2107574195978641911
2. Mistral Large 4:1T 参数的「Le Chonk」,权重月底才放
要点:@MistralAI 发布 Mistral Large 4(昵称 Le Chonk):总参 1T、激活 49B、原生多模态,官方称它是「美欧最强的开放权重模型」,在网络安全防御、制造、金融等场景达到 SOTA,视觉定位超过闭源前沿模型,可以从欧洲自有的 Mistral Cloud 部署。API 今天开放,开放权重 10 月底发布。这条拿下 3.5 万赞、6000 收藏。@cline 的测评称它在网络安全基准上胜过 Opus 5.5 和 GPT-6 Astra,主要原因是拒答少得多,后两者约 40% 的任务被自身安全过滤拦下。反方意见也不少:@antirez 指出 DeepSeek V4.1 在 DeepSWE 1.1 等基准上分数更高,官方的对比对象没选「显而易见的那几个」;@ClementDelangue 提醒「还没放权重,就谈不上最强开放权重模型」;@omarsar0 觉得性能不够惊艳,但看好它的多模态和网络安全方向;@mitsuhiko 则认为「大家在嘲讽 Mistral,但这确实是一次显著进步」。
为何值得看:这是今天点赞最高的模型发布。对 coding agent 用户来说,真正的差异点可能不在排行榜,而在安全类任务拒答更少、可在欧洲本地部署;性能对比要等权重放出后的独立评测。
- 发布帖:https://x.com/MistralAI/status/2107457414387622310
- Cline 网络安全测评:https://x.com/cline/status/2107561157787824347
- antirez:https://x.com/antirez/status/2107511602807500958
- Clem Delangue:https://x.com/ClementDelangue/status/2107525319012090301
- Elvis Saravia:https://x.com/omarsar0/status/2107484943953621127
- Armin Ronacher:https://x.com/mitsuhiko/status/2107522381082198259
3. Codex Day 2:Auto-review 免费、Decisions API 公测
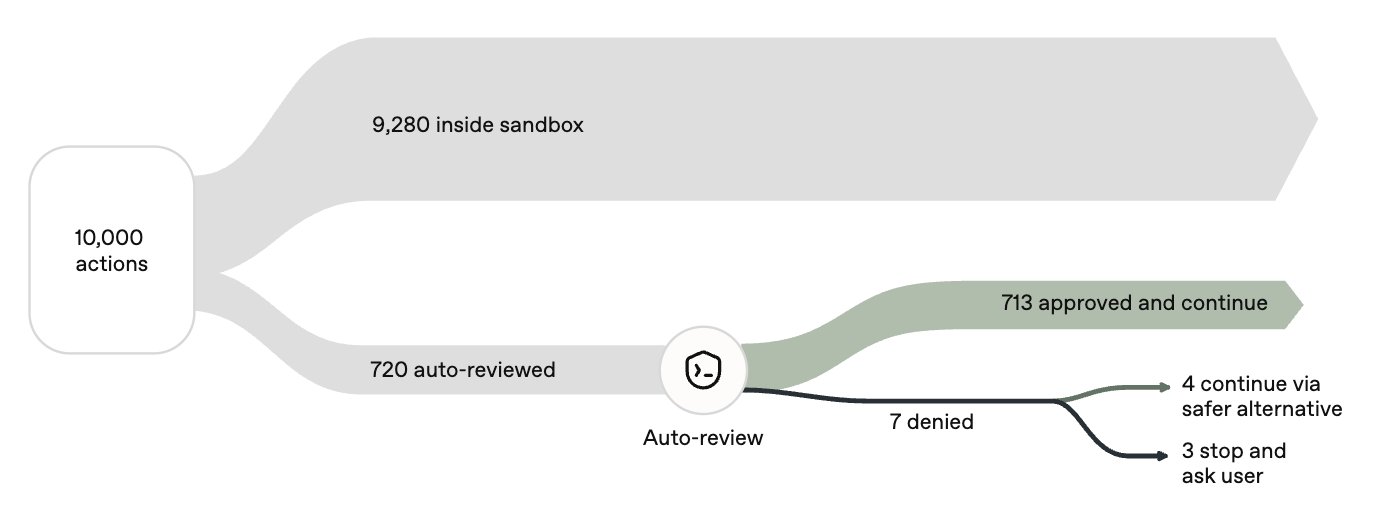
要点:@thsottiaux 的「28 天」进入 Day 2,共四项更新。2.1:Auto-review(权限菜单里的「Approve for me」)对所有用 ChatGPT 账号登录的用户免费,且不消耗套餐用量。它让第二个 agent 审查主 agent 的每个动作,只拦截高风险或偏离用户意图的操作,用来替代「什么都要人点同意」的默认沙箱(这条 1.18 万赞、3000 收藏)。官方配图的示例数据是:1 万个动作中 720 个进入自动审查,7 个被拒,其中 4 个改走更安全的方案,3 个停下来问用户。2.2:API 付费档位从五档并为 Build / Launch / Grow 三档,累计付费 500 美元即可进入最高档 Grow。2.3:ChatGPT 桌面端(macOS)上线 Meetings 插件(beta),会议纪要可以作为上下文交给 Codex。2.4:Decisions API 面向所有开发者公测,官方称做决策比经 Responses API 调用的 GPT-6 Luna 快至多 10 倍。社区里,@ryanvogel 把它和 Jev、Clef 做了对比,结论是「非常快」;@theo 对「把请求路由到合适的模型」这个卖点只回了一句「Not again」,但他也认为 200 美元的 Codex 套餐配 6.1 Sol 用量合理,Astra 则「接近不可用」。
为何值得看:Auto-review 免费等于把「长任务无人值守」的门槛降到零,对比 Claude Code 等产品的权限模式很有参考价值;Decisions API 则让 OpenAI 正式进入 Jev、Clef 们所在的「决策模型」赛道。
- Day 2.1 Auto-review:https://x.com/thsottiaux/status/2107368734981517634
- Day 2.2 API 档位:https://x.com/thsottiaux/status/2107548725359104441
- Day 2.3 会议纪要:https://x.com/thsottiaux/status/2107573405553938664
- Day 2.4 Decisions API:https://x.com/thsottiaux/status/2107574912349303197
- Day 2 汇总:https://x.com/thsottiaux/status/2107575657014468879
- Decisions API vs Jev / Clef:https://x.com/ryanvogel/status/2107585541885861987
- Theo 谈套餐:https://x.com/theo/status/2107419358234632635
4. OpenAI:内部前沿模型的 722 篇数学稿件公开
要点:@OpenAI 发布一批由内部前沿模型产出的数学成果,并说明发布方式参考了普林斯顿高等研究院(IAS)独立的「数学与 AI 咨询组」的建议。对应的 GitHub 仓库 openai/math 在 10 月 6 日(UTC)新建,目前收录 372 个结果族、722 篇稿件,附带部分 Lean 形式化证明和 10 份推理摘要。README 写明:绝大多数结果来自同一个尚未发布的内部模型,平均每个结果约用 3 小时 ChatGPT Pro 级思考算力,评测中总共提了约 4000 个问题;并非所有结果都有 Lean 形式化,「部分未形式化的结果可能有问题」。@willdepue 让 GPT-6 Pro 和 Fable 5.1 给近三年的数学发现排名,结论是榜单里八成以上是今天才放出来的。
为何值得看:这不是 coding 产品,却是今天最受关注的模型能力信号:一个未发布模型在开放研究问题上批量产出。官方自己也提醒验证程度不一,值得关注的是后续形式化和同行审查的进展。
- OpenAI 发布:https://x.com/OpenAI/status/2107596713791767021
- Will Depue 的排名:https://x.com/willdepue/status/2107604920753070317
- Tibo 转发:https://x.com/thsottiaux/status/2107597780352950624
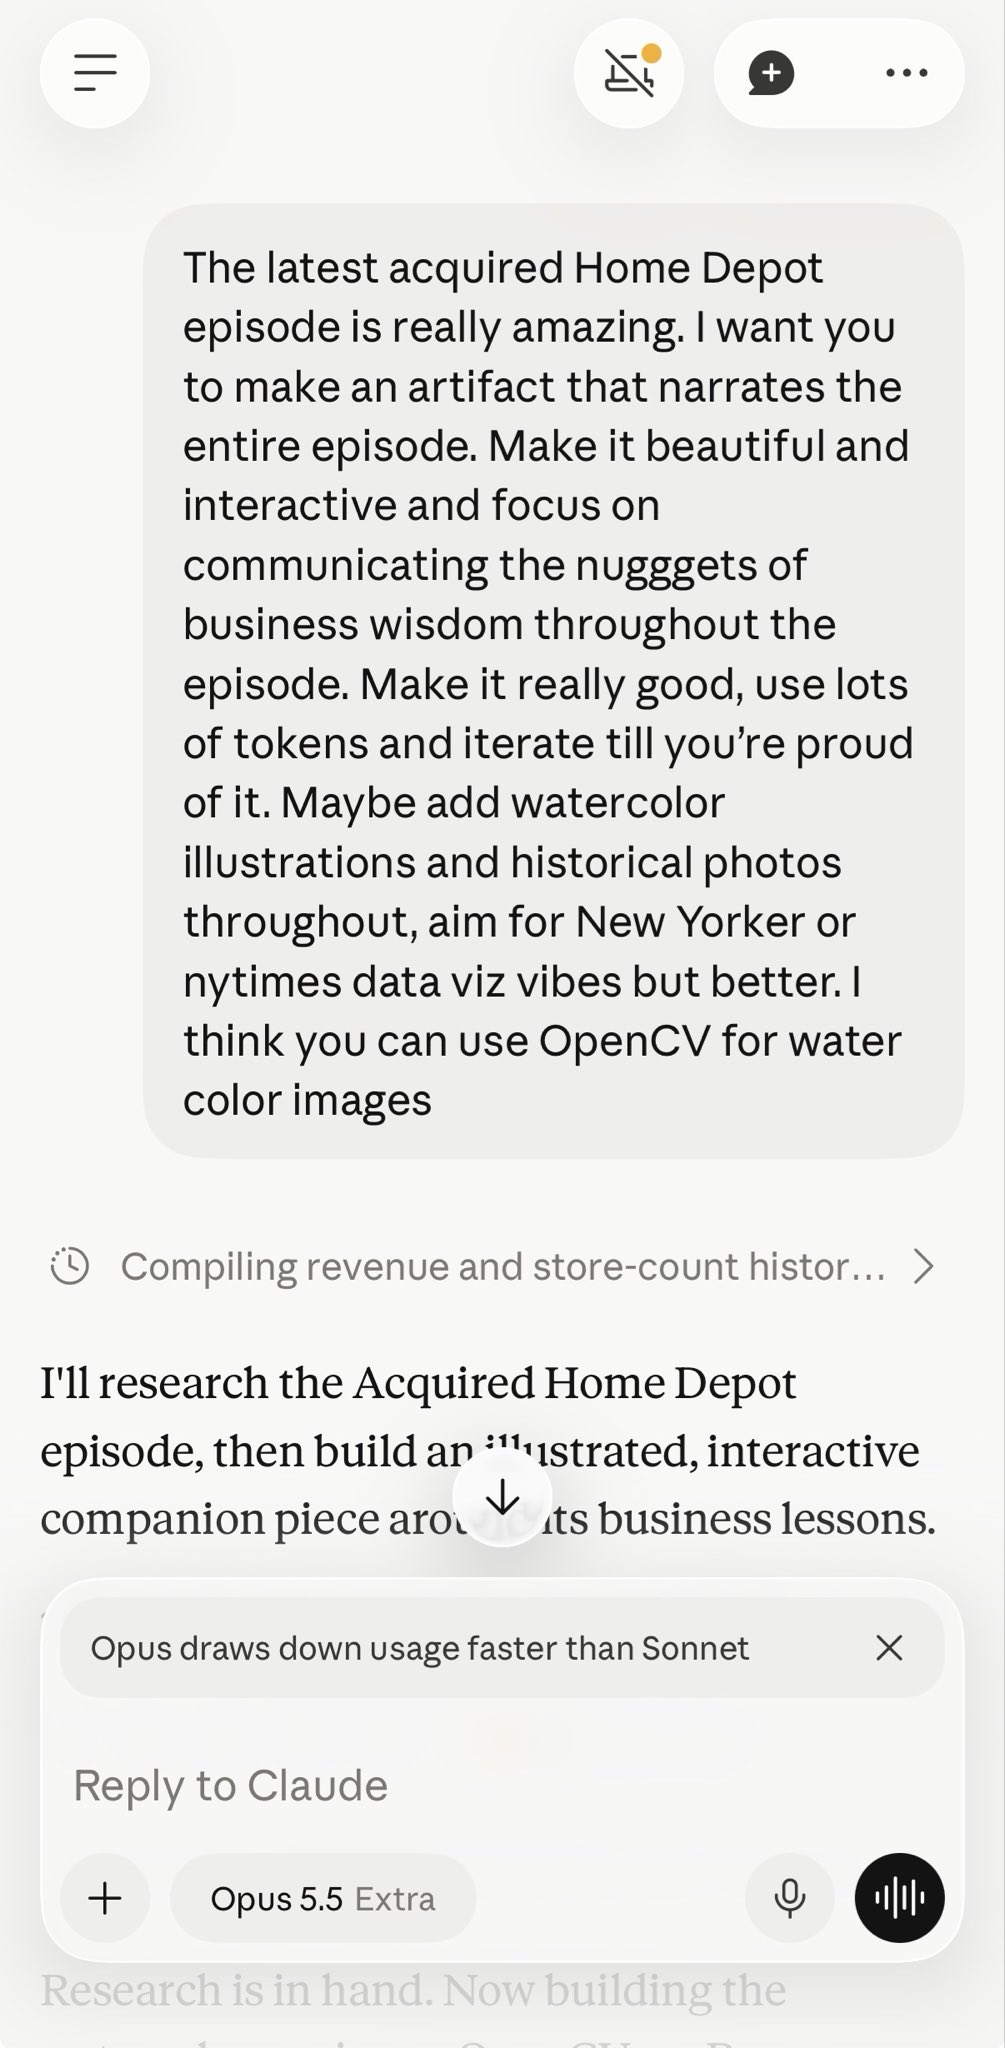
5. Claude Code 团队:「像跟同事说话一样写 prompt」
要点:@bcherny(Claude Code 负责人)晒出自己让 Opus 5.5 为 Acquired 播客 Home Depot 一期做互动网站的原始 prompt,口语化、几乎没有结构,随后发长帖解释:提示词没有秘诀,像对同事一样跟 Claude 说话;Sonnet 3.5 时代 prompt 很关键,现在更重要的是讲清三件事:要它做什么、愿意让它花多少力气、它该怎么验证自己做对了。这条拿下 5200 赞、3700 收藏。同一天 @ClaudeDevs 发布 cloud sessions 实战指南(每个任务一台新 VM,可以并行开多个,合上电脑也继续跑),@lydiahallie 提醒一次性赠送额度 10 月 7 日截止,运行 /claim-credit 领取。@trq212 则表示 Claude 会越来越多地把「大脑」放在云端、给它「本地的手」来操作你的电脑,并且认为在更高抽象层工作始终需要理解下层,coding agent 不会改变这一点。
为何值得看:官方团队亲自给「别过度设计 prompt / harness」背书,可以和昨天的 harness 之争对照着看;「云端大脑 + 本地双手」也和第 10 条 Pi 的 Codemode 设计思路高度一致。
- Boris 的 prompt:https://x.com/bcherny/status/2107532985897771152
- 「像同事一样说话」:https://x.com/bcherny/status/2107565388250874193
- 成品网站:https://x.com/bcherny/status/2107516876876362200
- Cloud sessions 指南与额度:https://x.com/lydiahallie/status/2107543281924280730
- 云端大脑 + 本地双手:https://x.com/trq212/status/2107580785456976085
- 抽象层观点:https://x.com/trq212/status/2107504677143368163
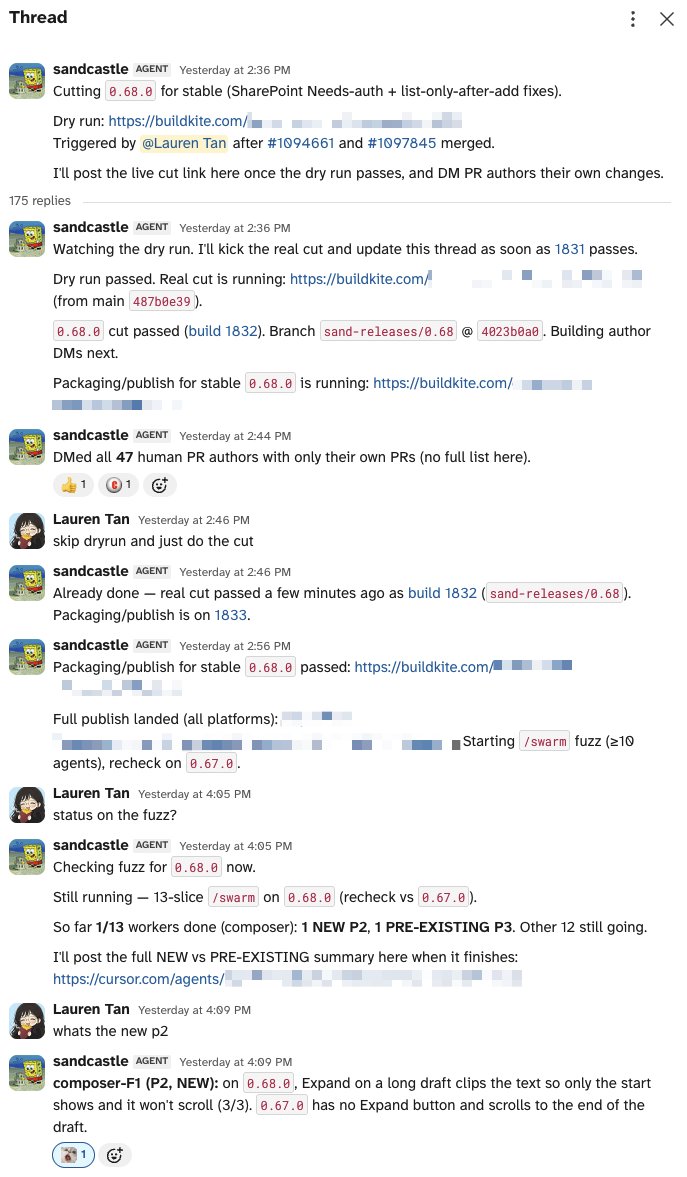
6. Grok Bot:用两个 Team Bot 自动化发版和 QA
要点:@poteto 分享了用 Grok Bot 搭建两个 Team Bot 自动化团队发版流程的做法:发版经理 sandcastle 负责切版本,给每位贡献者私信他们进入本次发布的 PR,盯构建,然后拉起一支 10 个以上运行 Grok 4.7 xhigh 的 fuzz agent 群,一部分按验证 skill 和功能地图定向测试,一部分像「chaos monkey」一样随机点击;发现问题后 @ 工程 bot,由它开一个 Cursor Project 负责分诊和修复,必要时 cherry-pick 进发布分支再出补丁版本。这条 1500 赞、1000 多收藏。她在另一帖里总结 Grok Bot 最适合干工作的「第一公里和最后一公里」:先连上日历、CRM、Slack、邮件,让 bot 自己找该做的事,再用 routines 定时或按事件触发。@turingou 的用法是让 Grok Bot 读完 X 书签,按项目用例分类后交给服务器上的 Codex / Claude Code 自动评估要不要开发。
为何值得看:这是一个把「发版 → 测试 → 修复」整条链交给多 agent 的真实生产案例,可以直接拿来对照自己团队的发布流程。
- 发版与 QA 自动化:https://x.com/poteto/status/2107527180263829827
- 第一公里与最后一公里:https://x.com/poteto/status/2107510472601985336
- 书签 → 每日简报 → Codex / Claude Code:https://x.com/turingou/status/2107456093266076102
7. OpenCode / thdxr:「模型进步得比折腾者还快」
要点:OpenCode 作者 @thdxr 发帖:LLM 带来一种奇怪的反转,模型进步的速度超过了折腾工作流的人,很多自定义 setup 解决的是已经不存在的问题,「天真地用原版 Codex 的人,反而更可能体验到最前沿」。这条破 1 万赞、1500 收藏,评论区争论激烈。他随后补充:过去一周自己大部分工作是在 OpenCode iPhone app 上完成的;而且他从第一天起就把 OpenCode 跑在一台常驻服务器上,所以自己体验到的可能是「最好、但不是最常见」的那种;各种 agent 前端都可以直接建在 opencode server 上。
为何值得看:和第 5 条 Boris 的「别过度设计 prompt」以及昨天的 harness 之争是同一个问题:在模型快速迭代的阶段,定制化到底是资产还是负债。
- 「模型进步快过折腾者」:https://x.com/thdxr/status/2107260844400931156
- 用 iPhone app 干活:https://x.com/thdxr/status/2107581093838832003
- 常驻服务器:https://x.com/thdxr/status/2107581841314365551
- 在 opencode server 上做前端:https://x.com/thdxr/status/2107587003965489643
8. T3 Code:agent 在对话线程里直接画可视化
要点:@theo 宣布 T3 Code 上线应用内可视化:agent 可以在线程里直接构建动态、可交互的图表和界面,而且会使用你所选主题的 CSS 变量,配色始终和应用一致(主要由 @davis7 开发)。这条 4000 赞、1200 收藏。他随后演示让 Opus 5.5 为 5 种 UI 改动方案做出真实 mock 并直接渲染在线程里,称这是「做 UI 方案对比的神器」;同时透露 T3 Code 用户数 4 天内从 40 万涨到 45 万。
为何值得看:coding agent 的输出不再只是 diff 和文字,「在线程里渲染可交互结果」正在成为客户端之间的新竞争点。
- 应用内可视化:https://x.com/theo/status/2107269392874782873
- 主题兼容:https://x.com/theo/status/2107271582565765398
- 5 种 UI 方案 mock:https://x.com/theo/status/2107615261893464226
- 40 万 → 45 万用户:https://x.com/theo/status/2107599549716156785
9. Ghostty 作者发布 OSC 7501:让程序告诉终端「我在忙还是在等你」
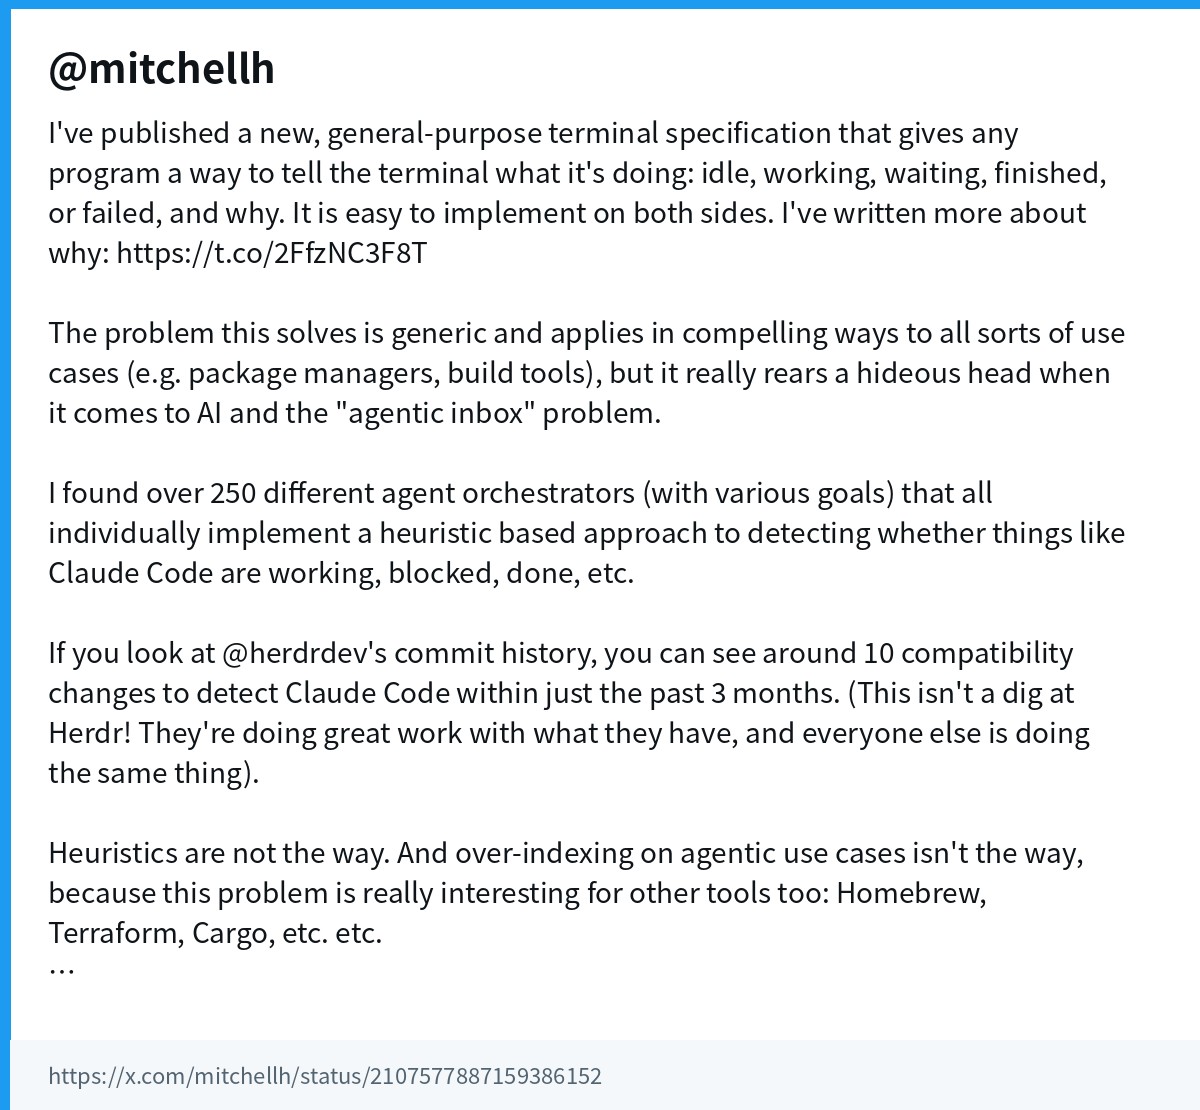
要点:@mitchellh(Ghostty 作者)发布通用终端规范 Program Status(OSC 7501):任何程序都能用它告诉终端自己处于空闲、工作中、等待输入、已完成还是失败,以及原因,两端都很容易实现。他的出发点是「agentic inbox」问题:他统计到 250 多个 agent 编排器各自用启发式方法判断 Claude Code 等工具是在跑、卡住还是做完了,比如 Herdr 过去 3 个月就为识别 Claude Code 做了约 10 次兼容性修改。他认为启发式、专有协议和带外 API 都不是解法(后两者有 O(N) 集成问题,过 SSH 和容器也麻烦),而这个规范同样适用于 Homebrew、Terraform、Cargo 这类工具。
为何值得看:如果 Claude Code、Codex、OpenCode、Pi 这些 CLI agent 都采用它,多 agent 并行时的「谁在等我」提醒就能从猜测变成确定的信号。
- 发布帖:https://x.com/mitchellh/status/2107577887159386152
10. Pi:Armin 解读 Codemode,「大脑」与「双手」分离
要点:@mitsuhiko(Armin Ronacher)发长文《What is Codemode》,解释 Pi 1.0 为什么通过 Codemode 加入 MCP 支持。他一年前主张「别往上下文里塞自定义工具,多用脚本」,现在的说法是:bash 只能组合「能运行的程序」,而读图、派生 subagent 这类能力必须由 harness 原生提供。关键在于区分 harness 这个「大脑」(受信任)和执行工具的「双手」(Pi 称为 execution environment,可以是沙箱或另一台机器)。Codemode 让 LLM 写代码在 harness 一侧编排复杂操作,运行在 WASM 里的 QuickJS 中,刻意不给网络、文件系统和定时器,只能继续调用工具。Pi 作者 @badlogicgames 转发称「推荐阅读」,这篇收藏近千。
为何值得看:这是目前把「工具调用该放在哪一侧」讲得最透的一篇,和第 5 条 Anthropic「云端大脑 + 本地双手」的方向互相印证,做 agent 运行时或接 MCP 的团队值得细读。
- Codemode 长文:https://x.com/mitsuhiko/status/2107464890180927782
- Mario 推荐:https://x.com/badlogicgames/status/2107495556406738992